Job backup lỗi thì dễ thấy: nó đỏ, nó gửi email. Job không hề chạy thì không để lại dấu vết nào, và báo cáo vẫn xanh. Bài cuối của chuỗi nói về cách bắt những job im lặng đó, và các bẫy khi phải quản lý nhiều Director cùng lúc.
Bài 11 kể các nguyên tắc thiết kế một lớp quản trị sinh cấu hình Bareos. Bài này trả lời hai câu hỏi còn lại: làm sao biết chắc mọi máy chủ đều có bản backup mới, và khi một máy chủ Bareos không còn đủ thì mở rộng thế nào mà không tự tạo thêm lỗi im lặng. Cuối bài là mười bài học quan trọng nhất rút ra từ cả chuỗi.
Vì sao job im lặng nguy hiểm hơn job lỗi
Hầu hết hệ thống giám sát backup hỏi câu: "đêm qua có job nào lỗi không?". Câu đó chỉ nhìn những job đã chạy. Một job không bao giờ được khởi động sẽ không có dòng nào trong catalog, nên cũng không bao giờ lỗi.
Những nguyên nhân thường gặp khiến job im lặng:
- Job hoặc Schedule bị
disableđể xử lý sự cố, rồi quên bật lại. - Cú pháp lịch sai, khiến job chỉ chạy vài ngày trong tháng thay vì mỗi ngày.
- Máy chủ bị gỡ khỏi cấu hình trong một lần dọn dẹp, không ai để ý.
- Một lần tạm dừng có hạn đã hết hạn nhưng cơ chế tự mở không chạy.
- Job kẹt trong hàng chờ vì giới hạn chạy song song, ngày này qua ngày khác.
Mọi trường hợp trên đều cho ra một báo cáo "0 job lỗi". Đó là lúc hệ thống đang hỏng mà trông như khoẻ.
Đổi câu hỏi: máy chủ nào quá N giờ chưa có bản thành công
Câu hỏi đúng không xoay quanh job, mà xoay quanh nguồn dữ liệu: với mỗi máy chủ lẽ ra phải được backup, lần thành công gần nhất là khi nào? Nếu quá N giờ, cảnh báo. Với lịch chạy mỗi ngày, N thường là 25 giờ: đủ một chu kỳ, cộng biên cho job chạy lâu.
Điểm mấu chốt: danh sách máy chủ lẽ ra phải backup không được lấy từ catalog. Catalog chỉ biết những gì đã chạy. Danh sách đó phải lấy từ nguồn sự thật bên ngoài, ví dụ cơ sở dữ liệu của lớp quản trị, hay đơn giản là một file liệt kê tên job mong đợi. Sau đó mới tra catalog để lấy lần thành công gần nhất:
-- Lần thành công gần nhất của từng job backup
SELECT Name, max(EndTime) AS lan_cuoi
FROM Job
WHERE Type = 'B'
  AND JobStatus IN ('T', 'W')
GROUP BY Name;
Job có trong danh sách mong đợi mà không có dòng nào ở kết quả trên, hoặc có mà lan_cuoi quá cũ, chính là job im lặng. Phép ghép nên làm ở tầng script, vì hai danh sách nằm ở hai nơi khác nhau.
Hai lưu ý khi đo thời gian:
- Cột thời gian của catalog là timestamp không múi giờ. Phiên làm việc với PostgreSQL phải đúng múi giờ của Director, như bài 2 và bài 8 đã nói, nếu không mốc 25 giờ lệch theo đúng độ lệch múi giờ.
- Kịch bản không chạy hằng ngày (vd chỉ chạy thứ Sáu) cần N riêng theo kịch bản. Dùng một N chung cho mọi thứ sẽ sinh cảnh báo giả, và cảnh báo giả làm người trực tắt thông báo.
Cảnh báo tức thì và tổng hợp buổi sáng
Hai loại cảnh báo phục vụ hai mục đích khác nhau:
| Cảnh báo tức thì | Tổng hợp buổi sáng | |
|---|---|---|
| Bắt cái gì | Job vừa lỗi, bị huỷ | Máy chủ quá N giờ chưa có bản thành công |
| Tần suất | Quét vài phút một lần | Một lần mỗi sáng, trước giờ làm việc |
| Khi mọi thứ ổn | Không gửi gì | Vẫn gửi một dòng "mọi máy chủ đều có bản mới" |
Dòng cuối của bảng là chi tiết quan trọng nhất. Nếu bản tổng hợp chỉ gửi khi có vấn đề, thì một buổi sáng im lặng có thể là "mọi thứ ổn", cũng có thể là "chính hệ thống cảnh báo đã chết". Gửi cả khi ổn thì sự im lặng tự nó thành tín hiệu. Và khi không đọc được catalog, phải gửi một tin lỗi riêng, không bao giờ gửi "mọi thứ ổn".
Kênh gửi có thể là email, hay một kênh chat như Telegram. Với Telegram, gửi tin chỉ cần một lệnh; token đọc từ file, không viết thẳng vào script:
TOKEN=$(cat /etc/qt/telegram.token)
curl -s -X POST "https://api.telegram.org/bot${TOKEN}/sendMessage" \
     -d chat_id=123456789 \
     --data-urlencode text="[backup01] 3 máy chủ quá 25 giờ chưa có bản thành công: web01, db01, web02"
Bẫy của cảnh báo tức thì: mốc JobId
Cách tự nhiên để không báo trùng là nhớ JobId lớn nhất đã xử lý, lần sau chỉ hỏi job có JobId lớn hơn. Cách này hỏng khi job chạy song song. Job có JobId nhỏ nhưng dữ liệu lớn có thể kết thúc (và lỗi) sau một job JobId lớn đã lỗi trước. Mốc đã vượt qua nó, nên nó không bao giờ được báo.
Các quy tắc mà chúng tôi rút ra:
- Mốc chỉ được tiến tới JobId nhỏ nhất đang chạy hoặc đang chờ, trừ một. Kèm một tập nhỏ "đã báo" để không báo lại job nằm trên mốc.
- Chỉ đánh dấu "đã báo" khi gửi tin thành công. Mạng lỗi tạm thời không được làm mất cảnh báo vĩnh viễn.
- Lần đầu chạy chỉ neo mốc, không bắn lại toàn bộ lịch sử cũ.
- Không đọc được catalog thì giữ nguyên mốc và thử lại, để job lỗi trong lúc gián đoạn vẫn được báo sau đó.
Khi nào thêm máy chủ Bareos thứ hai
Một máy chủ Bareos thường đủ cho khá nhiều nguồn dữ liệu. Lý do thêm máy thứ hai thường là một trong ba:
- Dung lượng hoặc băng thông: đĩa không nới được nữa, hoặc cửa sổ backup ban đêm không đủ.
- Chịu lỗi theo địa điểm: muốn khi mất cả một địa điểm, phía còn lại vẫn backup và vẫn khôi phục được.
- Tách miền lỗi: một sự cố cấu hình hay nâng cấp không kéo theo toàn bộ hệ thống.
Có hai cách mở rộng, cả hai đều là cách Bareos hỗ trợ chính thức:
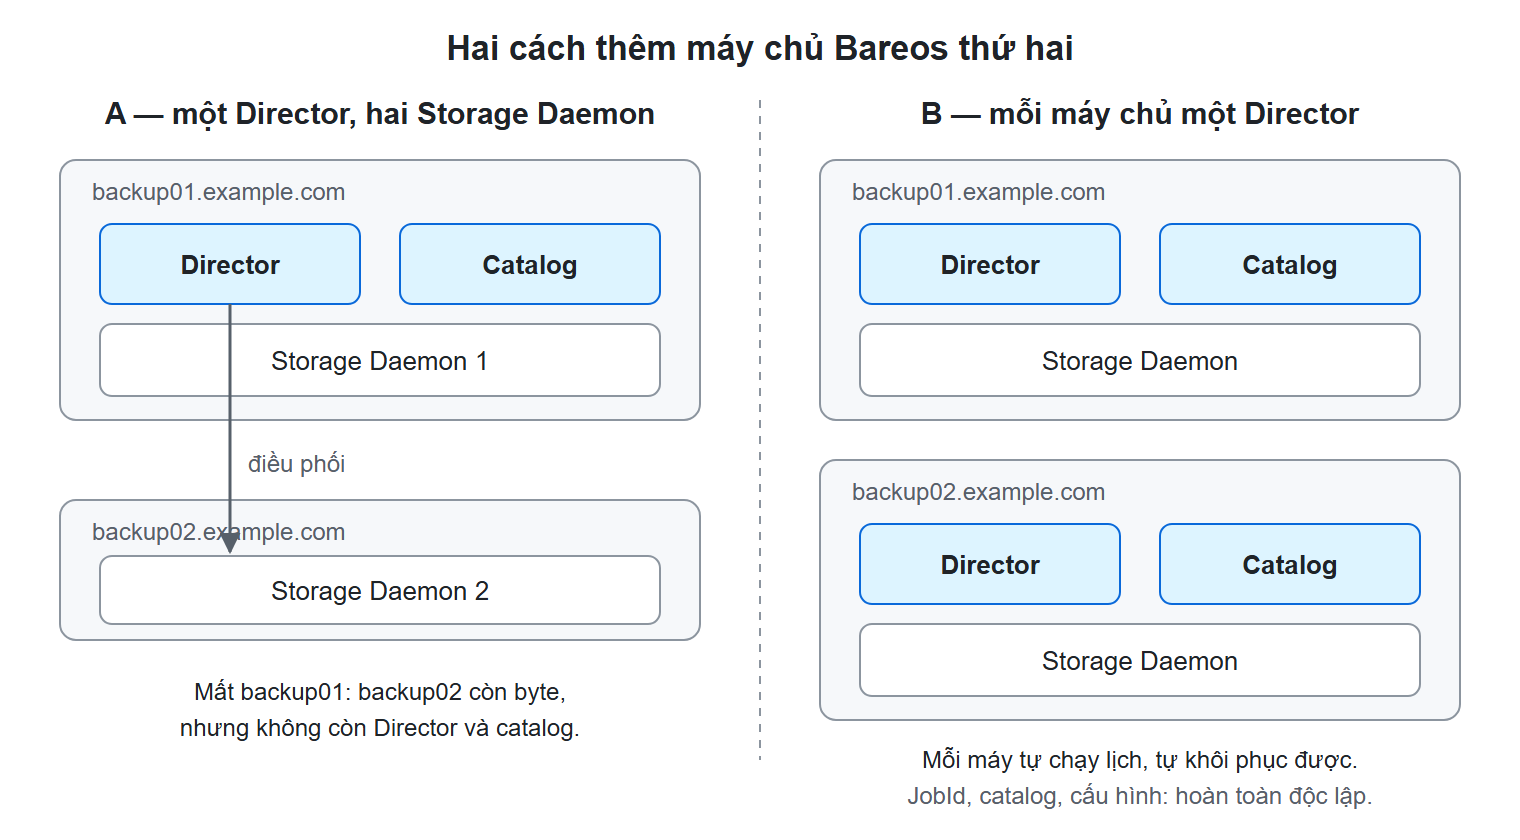
| A — thêm Storage Daemon, giữ một Director | B — mỗi máy chủ một Director + catalog riêng | |
|---|---|---|
| Cấu hình | Một nơi, thêm một resource Storage | Hai cây cấu hình độc lập |
| Tra cứu file | Một catalog cho mọi thứ | Phải biết máy chủ nào giữ nguồn nào |
| Mất máy chủ chứa Director | Byte còn trên máy kia, nhưng không còn ai điều phối, không còn catalog để biết byte đó là gì | Máy còn lại tự chạy lịch, tự khôi phục được |
| Công sức quản lý | Thấp | Cao, thường cần một lớp quản trị chung |
Nếu lý do chỉ là dung lượng, phương án A gọn hơn nhiều. Nếu lý do là chịu lỗi, phương án A không đạt: máy còn lại giữ được byte nhưng không giữ được khả năng dùng byte đó. Dựng lại catalog từ volume bằng bscan là việc làm tay, chậm, không phải "tự chạy tiếp". Khi đó phương án B là lựa chọn đúng, và cái giá của nó là phải quản nhiều Director.
Bẫy khi một giao diện quản nhiều Director
Thêm Director thứ hai vào một lớp quản trị vốn viết cho một máy là lúc lỗi im lặng xuất hiện nhiều nhất. Mọi chỗ trước đây ngầm hiểu "chỉ có một máy" đều thành nghi phạm.
Form ghi phải mang máy đích trong thân yêu cầu
Chúng tôi từng gặp một form áp dụng cấu hình không gửi kèm máy đích. Người dùng xem diff của máy thứ hai, bấm áp dụng, và yêu cầu rơi về máy mặc định. Vân tay kế hoạch có chứa khoá của máy nên lệch và bị từ chối: hỏng an toàn. Nhưng hậu quả là không bao giờ áp dụng được cho máy thứ hai, còn thông báo lỗi ("cấu hình đã thay đổi") thì nói sai nguyên nhân.
Bài học: mọi thao tác ghi phải mang máy đích trong thân yêu cầu, không dựa vào tham số trên URL. Thiếu máy đích thì từ chối, đừng tự đoán máy mặc định. Và cũng nên tránh kiểu "chọn máy đang làm việc" áp cho toàn giao diện; nó đổi ngầm mọi trang cùng lúc và dễ thao tác nhầm máy.
JobId của hai Director không liên quan gì nhau
Mỗi catalog đánh số JobId riêng. Catalog mới bắt đầu từ một, trong khi mốc cảnh báo chung đang ở vài nghìn. Hệ quả: truy vấn "job lỗi có JobId lớn hơn mốc" trên máy mới luôn rỗng. Mọi job lỗi ở đó không ai biết, trong khi hệ thống vẫn báo xanh.
Mọi trạng thái có dính tới JobId (mốc cảnh báo, liên kết tới trang chi tiết job, lệnh xoá job) phải đi kèm máy. Cùng lý do, tên job giống nhau ở hai máy là chuyện hợp lệ, nên kiểm trùng tên chỉ được làm trong phạm vi một máy.
UPDATE phải kiểm số dòng bị ảnh hưởng
Một lần, lệnh "bật lại tạm dừng cho máy B" chạy câu UPDATE … WHERE may = 'B'. Nhưng dòng đang chặn thực chất là dòng tạm dừng toàn hệ thống, không mang tên máy nào. Câu lệnh khớp đúng không dòng, không báo lỗi. Code chạy tiếp, gửi lệnh enable, ghi audit và nhắn "đã bật lại", trong khi cơ sở dữ liệu không đổi gì.
UPDATE tam_dung SET active = false
WHERE may = 'B' AND active
RETURNING may;
-- Không có dòng nào trả về: dừng lại, không báo thành công
Không có kết quả gộp, không có con số không nhãn
- Không có transaction xuyên máy. "Máy A xong, máy B lỗi" là kết quả hợp lệ và phải hiện đúng như thế, theo từng máy, không gộp thành một dòng "đã xong".
- Một máy mất kết nối không được làm sập giao diện của máy còn lại. Không đọc được thì hiện "không đọc được", không trả số 0.
- Mọi con số phải kèm nhãn máy. Cùng một tên pool có thể tồn tại ở cả hai máy với mức đầy khác nhau.
- Cẩn thận với JOIN. Trong giai đoạn chuyển nguồn dữ liệu từ máy này sang máy kia, một máy chủ có thể nằm trong nhóm ở cả hai Director. JOIN không lọc máy sẽ nhân đôi dòng, đếm hai lần. Dùng
EXISTSđể lọc.
Mười bài học quan trọng nhất của cả chuỗi
- Catalog quan trọng ngang dữ liệu. Backup catalog và đẩy bản dump ra ngoài máy chủ Bareos.
- Đặt múi giờ PostgreSQL đúng ngay từ lúc cài. Timestamp không múi giờ sẽ làm lệch mọi phép tính thời gian về sau.
- Đặt tên job theo ID ổn định của máy nguồn, lưu bảng ánh xạ ID ↔ tên riêng. Đổi tên job là mất chuỗi Incremental.
- Differential luôn tốn đĩa ít nhất bằng Incremental. Chỉ chọn nó khi mục tiêu là rút ngắn thời gian khôi phục.
- Dữ liệu hết hạn theo volume, không theo job. Không truncate thì đĩa phình tới đúng Maximum Volumes.
- Tính dung lượng theo đỉnh, không theo trung bình, và tính Incremental theo tổng thay đổi, không theo trung vị.
- Giá trị Maximum Concurrent Jobs thấp nhất trên đường đi mới là giá trị thật. Đo trên dữ liệu của chính mình.
- Backup chưa khôi phục thử là chưa có backup. Diễn tập định kỳ, đối chiếu checksum.
- bconsole thoát mã 0 cả khi thất bại, và
disablekhông bền. Tìm dấu hiệu thành công, ghi trạng thái vào file. - "Không đọc được" không phải "không có vấn đề". Giám sát cả những job lẽ ra phải chạy, và để hệ cảnh báo tự báo khi mọi thứ ổn.
Tóm tắt
- Job im lặng không để lại dấu vết trong catalog; bắt nó bằng câu hỏi "máy chủ nào quá N giờ chưa có bản thành công", với danh sách mong đợi lấy từ nguồn ngoài catalog.
- Kết hợp cảnh báo tức thì và tổng hợp buổi sáng, tổng hợp gửi cả khi mọi thứ ổn.
- Mốc cảnh báo theo JobId chỉ tiến tới job đang chạy nhỏ nhất, và phải tách riêng theo từng Director.
- Thêm máy chủ vì dung lượng thì thêm Storage Daemon; thêm vì chịu lỗi thì mỗi máy một Director + catalog riêng.
- Giao diện quản nhiều Director: thao tác ghi mang máy đích trong thân yêu cầu, UPDATE kiểm số dòng, kết quả và con số luôn theo từng máy.
Lời kết: Mười hai bài đi từ cài đặt, cấu hình, chính sách lưu giữ, dung lượng, catalog, diễn tập khôi phục, tới tự động hoá và giám sát. Bareos là một trong các giải pháp backup đáng cân nhắc, nhưng không có công cụ nào tự làm thay việc kiểm chứng. Hy vọng những bài học ở đây giúp bạn tránh được vài cái bẫy mà chúng tôi đã phải trả giá mới biết.
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.