Bài 10 nói về những cái bẫy im lặng khi tự động hoá bconsole. Khi số máy chủ tăng lên, các script rời rạc và file sửa tay thành nguồn lỗi chính; bước tiếp theo là gom chúng thành một lớp quản trị có dữ liệu gốc, có so khác biệt, có hoàn tác. Bài này chỉ nói nguyên tắc và bài học, không gắn với một công cụ hay giao diện cụ thể nào.
WebUI làm tốt gì, thiếu gì
WebUI đi kèm Bareos là công cụ theo dõi tốt. Vấn đề nằm ở chỗ nó gần như chỉ đọc đối với cấu hình:
| Việc | WebUI | Ghi chú |
|---|---|---|
| Xem job, log, trạng thái, volume | Tốt | Đọc thẳng từ catalog |
| Chạy job ngay, huỷ job, restore file | Có | Qua giao thức console |
| Tạo, sửa, xoá Job/FileSet/Schedule/Pool | Không | Phải sửa file trong bareos-dir.d/ |
| Gom máy chủ theo nhóm, áp một chính sách chung | Không | Mỗi job là một khối cấu hình riêng |
| Báo máy chủ lâu rồi không có bản thành công | Không | Chỉ thấy job đã chạy, không thấy job lẽ ra phải chạy |
| Ai đổi cấu hình gì, lúc nào | Không | Trừ khi tự đưa thư mục cấu hình vào git |
Giao thức console có lệnh configure add để thêm resource lúc đang chạy. Nhưng nó không có lệnh sửa hay xoá. Một lớp quản trị chỉ dùng API console sẽ thêm được job mà không bao giờ gỡ được: máy chủ đã rút khỏi chính sách vẫn backup mãi. Vì vậy lớp quản trị buộc phải ghi file thật trên máy chủ Director.
Nguyên tắc 1: cơ sở dữ liệu là nguồn gốc, file cấu hình chỉ là bản sinh ra từ đó
Sai lầm dễ mắc nhất là coi mỗi thao tác là một lệnh sửa file: thêm máy chủ thì ghi một file, bỏ máy chủ thì xoá một file. Cách đó hỏng ngay khi có một thao tác bị lỗi giữa chừng, vì không còn ai biết file nào lẽ ra phải tồn tại.
Cách bền hơn là lưu ý định trong cơ sở dữ liệu của lớp quản trị: máy chủ nào thuộc nhóm nào, nhóm dùng kịch bản nào. Mỗi lần áp dụng, tính lại toàn bộ cây cấu hình mong muốn từ đầu, rồi so với đĩa. File thừa thì xoá, file thiếu thì tạo, file lệch thì sửa. Máy chủ bị rút khỏi nhóm tự sinh ra lệnh xoá, không cần nhớ riêng.
# Minh hoạ: trạng thái mong muốn luôn tính từ toàn bộ dữ liệu
def trang_thai_mong_muon(db):
    files = {}
    for nhom in db.cac_nhom():
        kb = nhom.kich_ban
        if kb is None:          # nhóm chưa gán kịch bản: bỏ qua, kèm cảnh báo
            continue
        files[f"pool/ql-{kb.ten}.conf"] = render_pool(kb)
        files[f"schedule/ql-{kb.ten}.conf"] = render_schedule(kb)
        for may in nhom.may_chu:
            files[f"job/{may.ten_job}.conf"] = render_job(may, kb)
            files[f"fileset/{may.ten_job}.conf"] = render_fileset(may, kb)
    return files
Để so nhanh, chỉ cần một lệnh lấy hash của cả cây cấu hình, so với hash đã lưu, rồi mới kéo nội dung những file thật sự lệch. Cây có vài trăm file thì đọc từng file mỗi lần tính diff sẽ rất chậm, nhất là khi Director ở máy chủ khác.
Nguyên tắc 2: diff → kiểm tra → reload, lỗi thì rollback
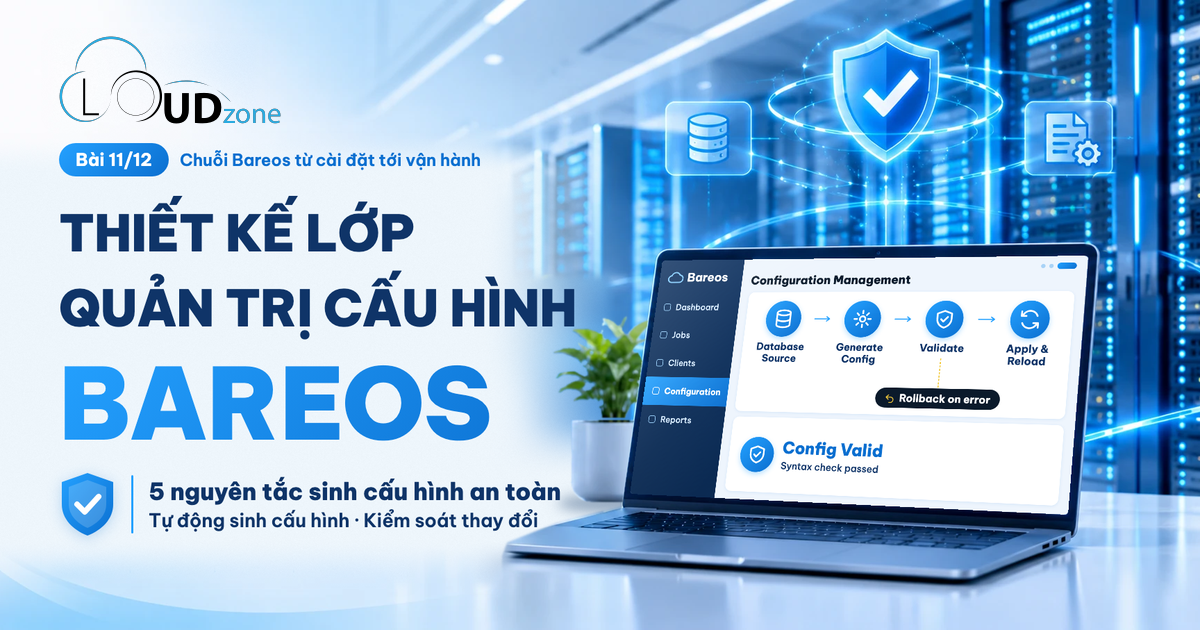
Luồng áp dụng cấu hình là phần quan trọng nhất của cả lớp quản trị. Sơ đồ dưới đây là một luồng nên dùng:
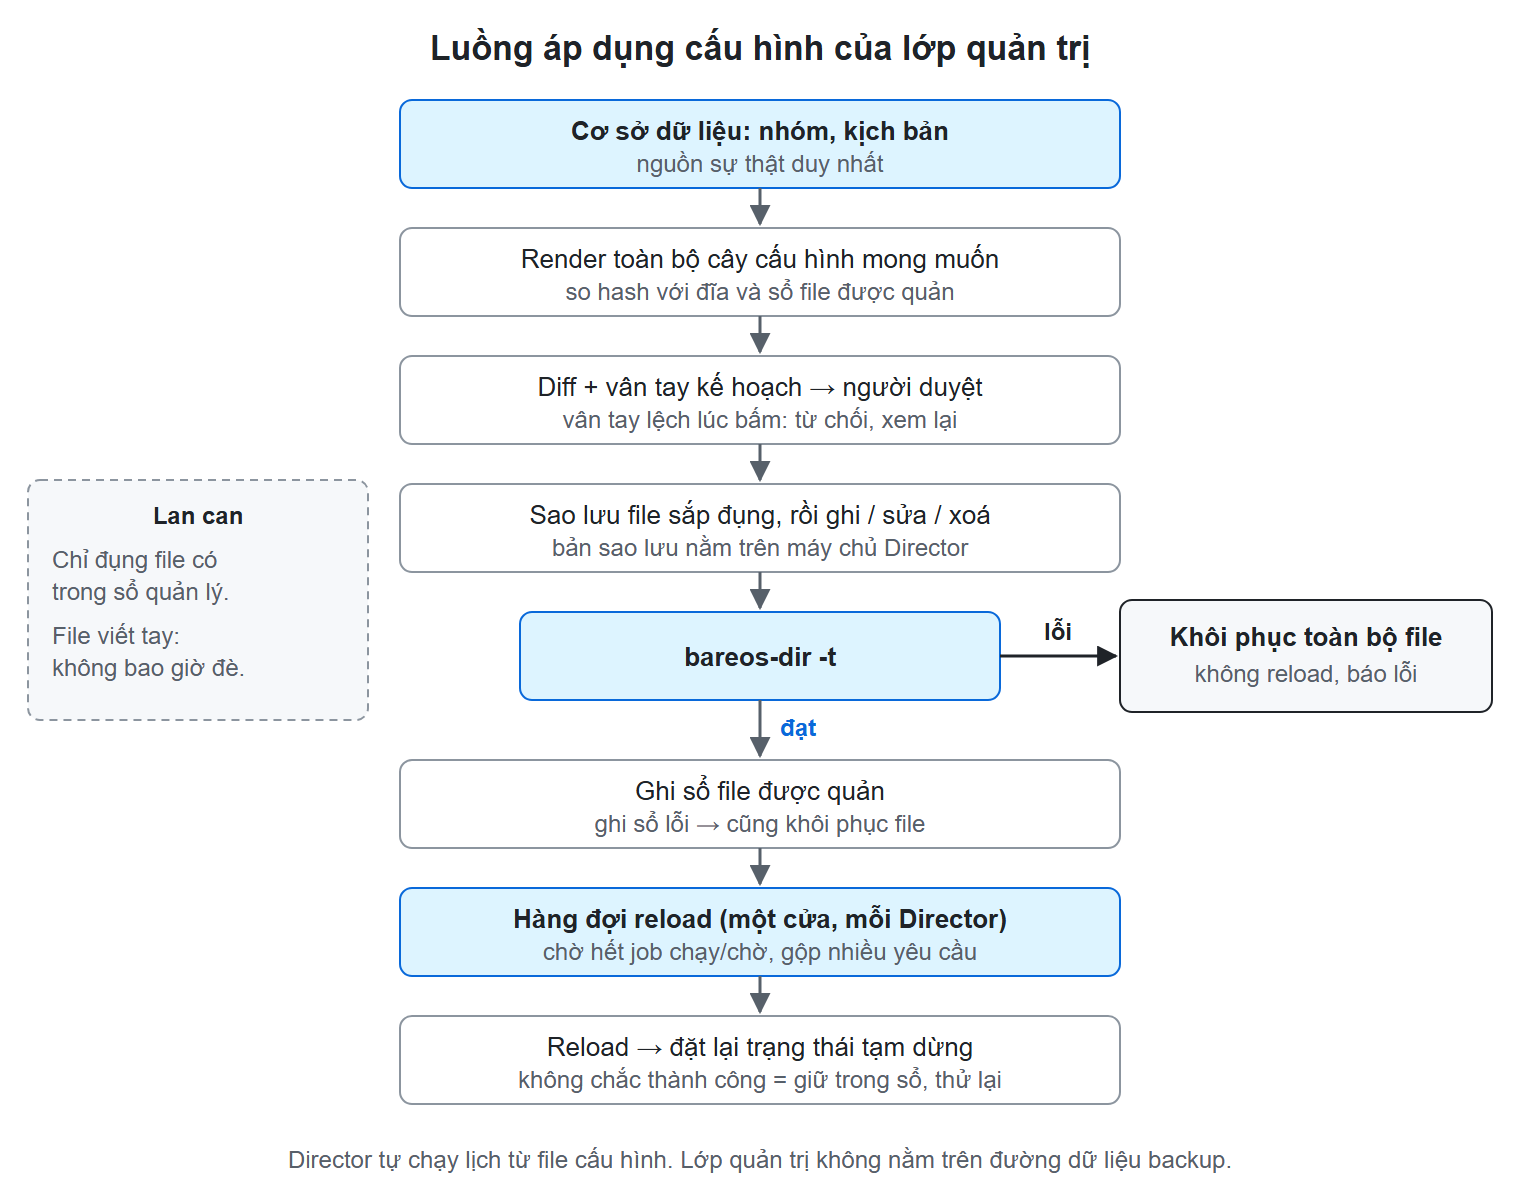
- Tính kế hoạch và cho người xem diff. Kế hoạch có một "vân tay" (hash của danh sách thay đổi và máy chủ đích).
- Người duyệt bấm áp dụng kèm vân tay đã xem. Tính lại kế hoạch; vân tay lệch nghĩa là có người đổi gì đó giữa chừng, từ chối và bắt xem lại.
- Sao lưu các file sắp bị đụng vào một thư mục có dấu thời gian, đặt trên chính máy chủ Director.
- Ghi, sửa, xoá file, rồi chạy
bareos-dir -tđể kiểm tra cú pháp toàn bộ cấu hình. - Kiểm tra lỗi thì khôi phục toàn bộ file từ bản sao lưu và dừng lại, không reload.
- Kiểm tra đạt thì ghi sổ các file đã quản, sau đó mới xin reload.
Thứ tự ở bước 6 có lý do. Nếu file đã nằm trên đĩa mà ghi sổ bị lỗi, file đó thành mồ côi: lớp quản trị không biết nó là của mình, lần sau sẽ không dám sửa hay xoá. Vì vậy ghi sổ lỗi cũng phải khôi phục file.
Bản sao lưu đặt trên máy chủ Director chứ không đặt trên máy chạy lớp quản trị. Lúc mạng chập chờn chính là lúc cần rollback nhất; rollback mà phụ thuộc vào cái mạng đó thì vô nghĩa. Ghi file nên ghi ra file tạm rồi mv, để không bao giờ có file ghi dở.
# Lõi của bước 4–5, chạy tại chỗ trên máy chủ Director
BK=/var/lib/lop-quan-tri/backups/$(date +%Y%m%d-%H%M%S)
mkdir -p "$BK"
cp -a /etc/bareos/bareos-dir.d/job/web01.conf "$BK/" 2>/dev/null
cp /tmp/web01.conf.new /etc/bareos/bareos-dir.d/job/web01.conf.tmp
mv /etc/bareos/bareos-dir.d/job/web01.conf.tmp /etc/bareos/bareos-dir.d/job/web01.conf
if ! bareos-dir -t -c /etc/bareos; then
    # khôi phục, không reload
    if [ -f "$BK/web01.conf" ]; then
        cp -a "$BK/web01.conf" /etc/bareos/bareos-dir.d/job/
    else
        rm -f /etc/bareos/bareos-dir.d/job/web01.conf   # file mới, chưa có bản cũ
    fi
    exit 1
fi
Nguyên tắc 3: chỉ đụng file của mình
Thư mục cấu hình gần như luôn có file viết tay: pool mặc định của gói cài, job backup catalog, vài job ai đó dựng trước khi có lớp quản trị. Một công cụ "đồng bộ cho giống cơ sở dữ liệu" rất dễ xoá sạch chúng. Hai chốt chặn giúp tránh chuyện đó:
- Bảng file được quản. Lớp quản trị chỉ sửa hoặc xoá file có tên trong bảng này. File tồn tại trên đĩa mà không có trong bảng thì không bao giờ bị đè; kế hoạch báo cảnh báo và dừng ở file đó.
- Tiền tố riêng cho pool, schedule, jobdefs do lớp quản trị sinh ra, ví dụ
ql-. Nhìn tên là biết file nào của ai, và không bao giờ trùng tên resource viết tay.
Một phép thử đáng làm mỗi lần nâng cấp lớp quản trị: render bằng code mới từ dữ liệu thật, rồi so từng byte với file đang chạy. Ngay sau khi triển khai, kế hoạch phải ra 0 thay đổi. Lệch một byte cũng là dấu hiệu code render đã đổi hành vi ngoài ý muốn.
Nguyên tắc 4: reload đi qua một cửa duy nhất
Reload Director lúc đang có job chạy thường vẫn được, nhưng tài liệu Bareos coi đó là tình huống phức tạp, có thể có tác dụng phụ. Khi nhiều chức năng cùng tự gọi reload, rất khó kiểm soát. Một cách làm gọn là một hàng đợi reload riêng cho mỗi Director:
- Chức năng nào đổi cấu hình chỉ xin reload, không tự gửi lệnh.
- Hàng đợi chỉ reload khi catalog xác nhận không còn job đang chạy hoặc đang chờ. Nhiều yêu cầu tới trong lúc chờ được gộp thành một lần reload.
- Một khoá theo máy chủ bao cả giai đoạn ghi file lẫn giai đoạn reload, để reload không bao giờ nạp cấu hình đang ghi dở.
- Reload báo lỗi hoặc quá giờ không có nghĩa là chưa chạy. Chỉ xoá yêu cầu khỏi sổ khi thành công rõ ràng; còn lại giữ và thử lại. Reload thừa một lần lúc rảnh là vô hại.
Một bài kiểm tra tự động quét mã nguồn, báo đỏ nếu có chỗ nào gọi reload mà không qua hàng đợi. Chốt chặn kiểu này rẻ, và nó giữ cho nguyên tắc không bị mục đi sau vài lần sửa.
Nguyên tắc 5: lớp quản trị không nằm trên đường dữ liệu
Director tự đọc Schedule và tự chạy job. Lớp quản trị chỉ sinh ra file cấu hình. Khi nó chết, backup vẫn chạy đúng lịch; cái mất là khả năng sửa chính sách và các cảnh báo. Điều này phải giữ đúng một cách có chủ đích:
- Không bao giờ để job phụ thuộc một script do lớp quản trị gọi theo giờ.
- Luôn giữ đường lui: bconsole và WebUI tại chỗ vẫn dùng được khi lớp quản trị không có.
- Cơ sở dữ liệu của lớp quản trị (nhóm, kịch bản, sổ file được quản, audit) cũng phải được dump ra ngoài máy chủ đang chạy nó.
Kịch bản và nhóm
Hai khái niệm này là thứ WebUI thiếu nhất. Kịch bản là một chính sách có tên: lịch Full, lịch Incremental, retention, trần số volume. Mỗi kịch bản sinh ra một pool riêng, để retention đi theo kịch bản. Nhóm là một tập máy chủ dùng chung một kịch bản; mỗi máy chủ chỉ thuộc tối đa một nhóm trên một Director, để tránh hai job backup cùng một nguồn.
Hai hệ quả dễ bị bỏ qua:
- Đổi kịch bản của một máy chủ là đổi pool. Bản Full cũ nằm ở pool cũ, các bản Incremental mới ghi vào pool mới. Nếu pool cũ có retention ngắn hơn, bản Full có thể bị prune trước và chuỗi khôi phục đứt. Lớp quản trị nên cảnh báo và khuyên chạy một bản Full, nhưng không nên tự chạy Full hàng loạt: chuyển một trăm máy chủ rồi tự chạy một trăm Full cùng lúc sẽ dồn tải nặng.
- Sửa retention của kịch bản không tự áp vào volume cũ. File pool mới chỉ có tác dụng với volume tạo sau đó. Pool trong catalog cần
update pool, volume đã có cầnupdate volumetheo pool. Chiều nâng retention nguy hiểm hơn chiều hạ: volume cũ vẫn hết hạn theo con số cũ, tức mất dữ liệu mà mình tưởng đang giữ.
Tạm dừng phải bền
Như bài 10 đã nói, lệnh disable chỉ sống trong bộ nhớ Director và mất sau reload. Một lớp quản trị mà reload thường xuyên sẽ vô tình "bật lại" mọi thứ đang tạm dừng. Cách xử lý:
- Tạm dừng một kịch bản thì ghi
Enabled = Novào file Schedule, render từ cơ sở dữ liệu. Lần áp dụng nào sau đó, do ai gây ra, cũng tự tính lại đúng dòng này. - Tạm dừng thứ không nằm trong file mình quản (vd một Client dùng chung) thì phải đặt lại trạng thái sau mỗi lần reload. Reload tay ngoài lớp quản trị thì không bắt được; đó là giới hạn cần ghi rõ.
disablemột Schedule không chặn được lệnhrunchạy tay. Muốn chặn thì chặn ở chính lớp quản trị.
Không có nút restore, và mọi thao tác ghi đều có audit
Lớp quản trị không nên có chức năng restore. Tài khoản nó dùng chỉ cần quyền đọc dữ liệu nguồn để backup. Quyền ghi đè ngược lại vào hệ thống thật được cấp riêng, theo quy trình riêng, có người duyệt. Một công cụ vừa backup vừa ghi đè được là một điểm tấn công quá hấp dẫn.
Mọi thao tác ghi (tạo nhóm, áp dụng cấu hình, chạy ngay, tạm dừng) đều vào bảng audit: ai, lúc nào, làm gì, diff ra sao. Việc do tác vụ nền tự làm (vd tự mở tạm dừng khi hết hạn) ghi người thực hiện là "hệ thống", không mượn tên người dùng cuối.
Bẫy và bài học
- "Không đọc được" khác "không có gì thay đổi". Khi không kết nối được Director, hàm tính diff trả danh sách rỗng. Nếu giao diện hiểu đó là "0 thay đổi", hệ thống báo xanh trong lúc đang mù. Phải có trạng thái lỗi riêng, hiện rõ.
- Catalog tạo bằng encoding
SQL_ASCII. Một ký tự tiếng Việt trong chuỗi SQL, kể cả trong dòng comment, có thể làm driver từ chối cả câu lệnh. Giữ mọi câu SQL gửi tới catalog là ASCII. - Test quét mã nguồn kiểm hình dạng, không kiểm code chạy được. Ví dụ một biến đúng tên nhưng chưa bao giờ được gán: bộ quét cho qua, trang thì lỗi. Sau mỗi đợt sửa hàng loạt, cần một bài test gọi thật mọi đường dẫn.
- Nhánh code chưa bao giờ chạy thật thì chưa ai soát nội dung nó sinh ra. Cách rẻ nhất là render thử và đọc, trước khi áp dụng.
Tóm tắt
- WebUI theo dõi tốt nhưng không sửa được cấu hình; API console thêm được resource mà không gỡ được, nên lớp quản trị phải ghi file.
- Lưu ý định trong cơ sở dữ liệu, tính lại toàn bộ cấu hình mỗi lần, so diff bằng hash.
- Luồng áp dụng: vân tay → sao lưu → ghi →
bareos-dir -t→ lỗi thì rollback, đạt thì ghi sổ rồi xin reload qua một hàng đợi duy nhất. - Chỉ đụng file có trong sổ quản lý, dùng tiền tố riêng; lớp quản trị không bao giờ nằm trên đường dữ liệu.
- Tạm dừng ghi vào file cho bền, không có nút restore, mọi thao tác ghi đều có audit.
Không muốn tự xây và duy trì lớp quản trị cho hệ thống sao lưu, Quý khách hàng có thể chat với Cloudzone để được tư vấn Backup as a Service.
Bài sau: Giám sát Bareos: bắt job im lặng và quản nhiều Director: bắt những máy chủ lẽ ra phải backup mà không chạy, và các bẫy khi một giao diện quản nhiều máy chủ Bareos.
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.