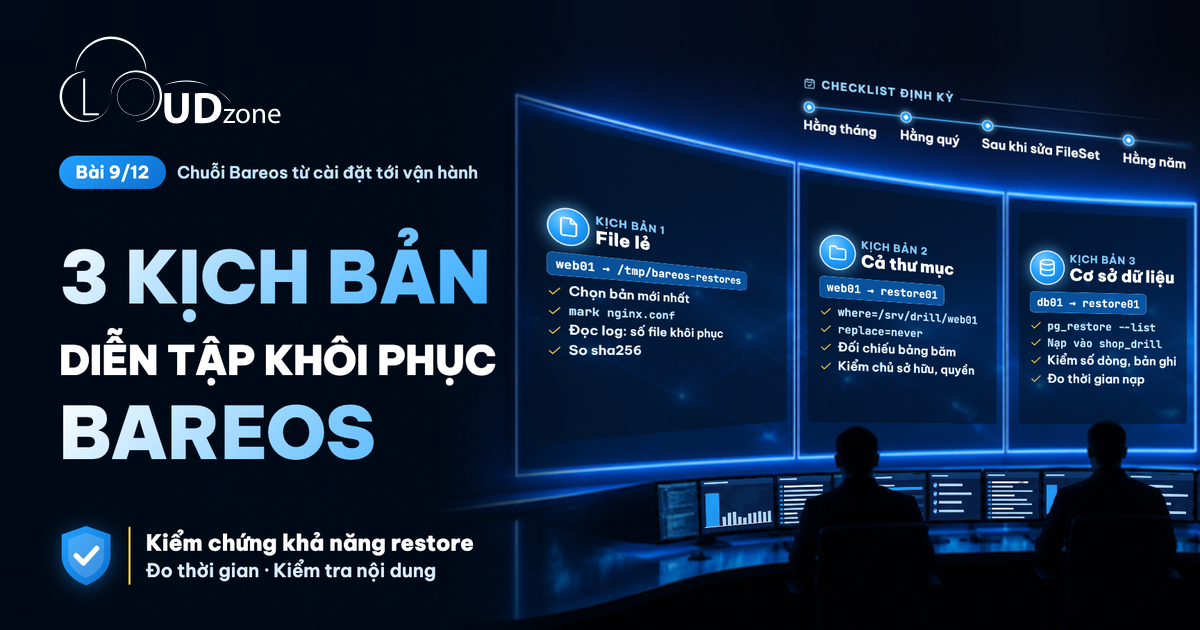
Bài 8 nói về catalog, cuốn sổ giúp Bareos biết file nào nằm ở đâu. Bài này dùng cuốn sổ đó để làm việc chính của một hệ thống backup: lấy dữ liệu ra. Chúng ta sẽ đi qua một buổi diễn tập trên máy chủ Linux gồm ba bài thử: restore một file lẻ, restore cả thư mục sang máy khác, và restore một cơ sở dữ liệu. Sau đó là cách ước lượng thời gian restore, cách tách quyền, và một checklist để diễn tập định kỳ.
Vì sao job backup báo OK vẫn có thể không khôi phục được
Trạng thái job chỉ phản ánh tầng ghi. Những lỗi dưới đây đều cho ra job báo thành công đều đặn, và chỉ lộ ra khi restore:
- FileSet sót thư mục. Ứng dụng chuyển dữ liệu từ
/var/wwwsang/srv/data, nhưng FileSet vẫn chỉ lấy thư mục cũ. - Exclude quá rộng. Một mẫu loại trừ
*.tmphaycachekhớp nhầm cả thư mục có dữ liệu thật. - File dump cơ sở dữ liệu rỗng hoặc dở dang. Script tạo dump chạy trước job bị lỗi, nhưng job vẫn lấy file đó như thường.
- Khôi phục được nhưng không chạy được. Sai chủ sở hữu, sai quyền, thiếu file cấu hình nằm ngoài FileSet.
Chuyện job báo thành công đều đặn mà lần restore thử đầu tiên lại thất bại không hiếm: lỗi nằm ở đường khôi phục, thứ chưa ai từng đi qua. Vì vậy câu “backup chưa restore thử là chưa có backup” nghe hơi cực đoan, nhưng thường đúng. Phần lý do chung đã có ở bài Có backup vẫn mất dữ liệu; bài này đi vào cách làm trên Bareos.
Chuẩn bị trước buổi diễn tập
Nguyên tắc số một: không restore đè lên máy chủ đang chạy. Buổi diễn tập nên ghi ra một thư mục riêng, hoặc tốt hơn là sang một máy chủ riêng, ví dụ restore01 có cài File Daemon. Job restore mặc định của gói Bareos thường tên RestoreFiles, ghi vào /tmp/bareos-restores. Nên mở file cấu hình của nó ra xem giá trị Replace trước khi dùng: không khai thì Bareos mặc định Replace = Always, tức ghi đè.
Các tham số của lệnh restore trong bconsole hay dùng nhất:
| Tham số | Ý nghĩa | Gợi ý khi diễn tập |
|---|---|---|
client= | Máy chủ nguồn đã được backup | Tên File Daemon, vd web01-fd |
restoreclient= | Máy chủ nhận dữ liệu, nếu khác máy nguồn | restore01-fd |
where= | Thư mục gốc để ghi dữ liệu ra | Luôn đặt, đừng để trống |
replace= | Gặp file đã có thì làm gì: always, never, ifnewer, ifolder | never cho an toàn |
current | Lấy bản mới nhất | Dùng cho bài thử thường kỳ |
before= | Lấy bản gần nhất trước một thời điểm | Thử khôi phục về mốc trước sự cố |
jobid= | Chỉ định chính xác job cần lấy | Khi cần đúng một bản cụ thể |
Một chi tiết hay làm người mới bối rối: dữ liệu được ghi ra dưới where= kèm nguyên đường dẫn gốc. File /etc/nginx/nginx.conf restore với where=/tmp/bareos-restores sẽ nằm ở /tmp/bareos-restores/etc/nginx/nginx.conf.
Bài thử 1: restore một file lẻ trong Bareos
Đây là yêu cầu hay gặp nhất ngoài thực tế: ai đó sửa hỏng một file cấu hình và cần bản của đêm qua. Chạy tương tác trong bconsole là cách dễ học nhất. Gõ restore client=web01-fd, chọn mục “bản mới nhất của một client”, Bareos dựng cây thư mục từ catalog. Bạn di chuyển bằng cd, ls, đánh dấu bằng mark, rồi gõ done.
Để diễn tập lặp lại được, có thể đưa đúng chuỗi thao tác đó vào bconsole qua stdin:
timeout 600 bconsole <<'BC'
restore client=web01-fd fileset=web01-fs where=/tmp/bareos-restores current
cd /etc/nginx
mark nginx.conf
done
yes
wait
messages
BC
sha256sum /etc/nginx/nginx.conf /tmp/bareos-restores/etc/nginx/nginx.conf
Lệnh wait giữ bconsole lại tới khi job xong, messages in log của job ra. Hai điểm cần đọc trong log: trạng thái kết thúc và số file đã khôi phục. Nếu số file là 0, lệnh mark đã không khớp gì, dù job vẫn có thể báo thành công.
So sha256sum với file đang chạy chỉ có nghĩa khi file đó chưa đổi kể từ lần backup. Với file hay thay đổi, hãy so với nội dung bạn biết chắc, hoặc dùng cách lập bảng băm lúc backup ở bài thử 2.
Bài thử 2: restore cả thư mục sang máy chủ khác
Bài thử này mô phỏng tình huống mất hẳn web01. Dữ liệu được đưa sang restore01, dưới một thư mục riêng:
restore client=web01-fd restoreclient=restore01-fd where=/srv/drill/web01 replace=never current all done yesCâu hỏi khó hơn là: làm sao biết hàng chục nghìn file đã về đủ và đúng? So với máy nguồn không ổn, vì máy nguồn đã thay đổi từ lúc backup. Một cách làm gọn là lập bảng băm ngay lúc backup, rồi backup luôn bảng băm đó. Đoạn dưới chạy trên web01 qua ClientRunBeforeJob, và file /var/backups/www.sha256 nằm trong FileSet:
set -euo pipefail
# Chạy trên web01 trong ClientRunBeforeJob: lập bảng băm lúc backup
cd /var/www
find . -type f ! -path './cache/*' -print0 \
  | sort -z \
  | xargs -0 sha256sum > /var/backups/www.sha256
Sau khi restore, kiểm trên restore01. Bảng băm và dữ liệu về cùng một lần, nên phép so không phụ thuộc máy nguồn còn sống hay không:
set -uo pipefail
# Chạy trên restore01 sau khi restore xong
cd /srv/drill/web01/var/www
if sha256sum -c --quiet /srv/drill/web01/var/backups/www.sha256; then
  echo "Khớp toàn bộ"
else
  echo "Có file lệch, xem danh sách ở trên" >&2
fi
Cách này tốn thêm một lượt đọc toàn bộ thư mục mỗi lần backup, nên hợp với dữ liệu vừa phải, ít thay đổi như mã nguồn web. File thay đổi trong lúc đang lập bảng băm sẽ lệch, đó là báo động giả dễ nhận ra. Bareos cũng có job loại Verify để đối chiếu dữ liệu với catalog, là một lựa chọn khác đáng thử.
Ngoài nội dung, hãy kiểm chủ sở hữu và quyền. Bareos khôi phục theo UID/GID dạng số. Nếu restore01 không có cùng người dùng với cùng số hiệu, file sẽ mang chủ sở hữu lạ. Ứng dụng có thể không đọc được dù nội dung đúng hoàn toàn.
Bài thử 3: restore một cơ sở dữ liệu
Backup thẳng thư mục dữ liệu của PostgreSQL hay MySQL khi dịch vụ đang chạy thường cho ra bản không nhất quán. Cách phổ biến là chạy lệnh dump trước job, rồi để Bareos lấy file dump. Đoạn chạy trên db01:
set -euo pipefail
# ClientRunBeforeJob trên db01. set -e và test -s làm job thất bại khi pg_dump lỗi hoặc ra file rỗng.
pg_dump -Fc -d shop -f /var/backups/pg/shop.dump
test -s /var/backups/pg/shop.dump
Dòng set -euo pipefail và test -s không phải trang trí. Kiểu viết pg_dump … | gzip > file.gz không có pipefail sẽ trả về mã thoát của gzip. Khi pg_dump lỗi giữa chừng, bạn vẫn có một file nén hợp lệ, chứa dữ liệu dở dang. Script báo lỗi thì ClientRunBeforeJob mới làm job thất bại được.
Restore file dump sang restore01 như bài thử 2, rồi nạp thử vào một cơ sở dữ liệu tạm:
set -euo pipefail
DUMP=/srv/drill/db01/var/backups/pg/shop.dump

# 1. File đọc được và đúng định dạng
pg_restore --list "$DUMP" > /dev/null

# 2. Nạp vào một cơ sở dữ liệu tạm, tính giờ
bat_dau=$(date +%s)
dropdb --if-exists shop_drill
createdb shop_drill
pg_restore -d shop_drill --no-owner -j 4 "$DUMP"
echo "Nạp mất $(( $(date +%s) - bat_dau )) giây"

# 3. Kiểm nội dung: số dòng và bản ghi mới nhất
psql -d shop_drill -At -c "SELECT count(*) FROM orders;"
psql -d shop_drill -At -c "SELECT max(created_at) FROM orders;"
Ba bước kiểm có mục đích khác nhau. pg_restore --list xác nhận file không hỏng. Việc nạp thật xác nhận dump dùng được và cho biết mất bao lâu. Hai câu truy vấn cuối xác nhận nội dung hợp lý: số dòng không bằng 0, bản ghi mới nhất gần đúng giờ backup. Nếu bản ghi mới nhất cũ hơn vài ngày, rất có thể dump đang lấy nhầm cơ sở dữ liệu hoặc nhầm máy.
Ước lượng thời gian restore: Full cộng chuỗi Incremental
Muốn khôi phục về mốc mới nhất, Bareos phải đọc bản Full gần nhất và gần như toàn bộ chuỗi Incremental sau nó. Dung lượng phải đọc vì thế không bằng dung lượng dữ liệu trên máy chủ. Nó bằng dung lượng Full cộng tổng mọi thay đổi trong chu kỳ, kể cả những file đã bị ghi đè nhiều lần.
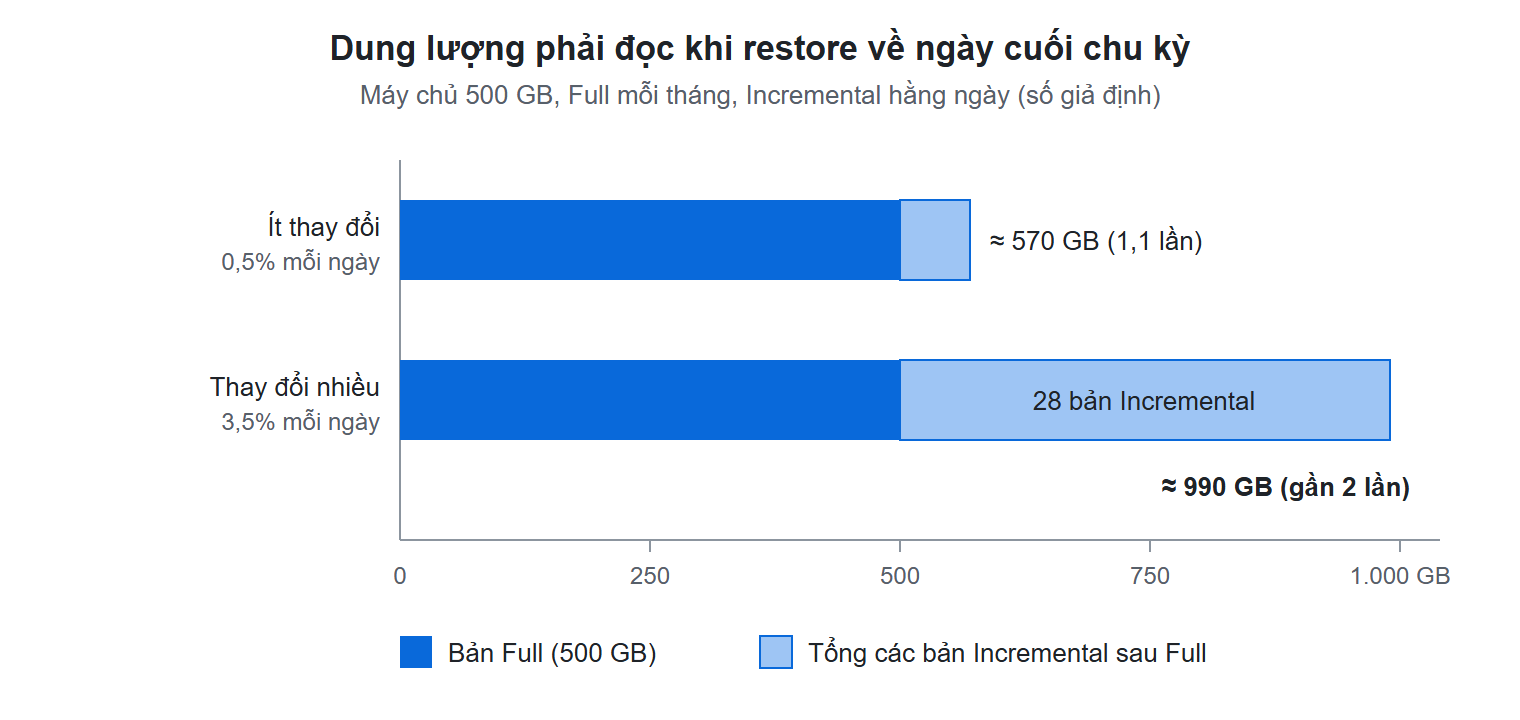
Ví dụ với số giả định: máy chủ có 500 GB dữ liệu, Full mỗi tháng, Incremental hằng ngày. Nếu mỗi ngày thay đổi khoảng 3,5%, ngày cuối chu kỳ phải đọc khoảng 500 + 28 × 17,5 ≈ 990 GB. Tức là gần gấp đôi dung lượng thật. Máy chủ cơ sở dữ liệu hay máy chủ log thường có tỷ lệ thay đổi cao như vậy, thậm chí hơn.
Một job restore thường chạy một luồng, nên tốc độ đo được ở một luồng mới là con số để tính. Ở 100 MB/s, đọc 990 GB mất gần 3 giờ, chưa tính thời gian nạp lại cơ sở dữ liệu. Nếu con số đó vượt quá thời gian khôi phục mục tiêu, có vài hướng xử lý:
- Rút ngắn chu kỳ Full cho riêng các máy chủ thay đổi nhiều.
- Dùng Differential cho các máy chủ đó: tốn đĩa hơn, nhưng restore chỉ đọc Full cộng một bản (xem bài 4).
- Dùng Virtual Full để ghép bản Full mới ngay trên máy backup, không phải đọc lại máy nguồn.
Điều quan trọng là đo thật trong buổi diễn tập, ghi lại số byte đã đọc và thời gian. Ước lượng trên giấy thường lạc quan hơn thực tế, vì nó bỏ qua phần nạp dữ liệu và kiểm tra sau restore.
Tách quyền backup và quyền ghi đè
Quyền backup chỉ đọc dữ liệu từ máy chủ. Quyền restore thì ghi được lên máy chủ, với replace=always là ghi đè. Hai quyền này có mức rủi ro rất khác nhau, nên đừng để chúng chung một tài khoản.
Bareos cho phép tạo nhiều Console có tên, mỗi Console gắn một Profile giới hạn lệnh được dùng. Tài khoản dùng cho script tự động hoặc cho người trực ca có thể bị cấm hẳn lệnh restore:
Profile {
  Name = backup-operator
  Command ACL = !restore, !delete, !purge, *all*
  Job ACL = *all*
  Client ACL = *all*
  Storage ACL = *all*
  Schedule ACL = *all*
  Pool ACL = *all*
  FileSet ACL = *all*
  Catalog ACL = *all*
  Where ACL = *all*
}

Console {
  Name = automation
  Password = "mat-khau-rieng-cho-console-nay"
  Profile = backup-operator
}
Quyền restore thì giao cho một Console khác, ít người giữ. Có thể siết thêm Where ACL để Console đó chỉ được ghi vào thư mục diễn tập. Ở phía máy chủ nguồn, File Daemon có directive Allowed Job Command (khai trong resource Director của bareos-fd) để chỉ nhận những loại job được phép, ví dụ backup và estimate; máy không cần nhận restore thì bỏ restore khỏi danh sách. Tách quyền như vậy nghe phiền, nhưng nó chặn được kịch bản tệ nhất: một script lỗi hoặc một tài khoản bị lộ ghi đè dữ liệu cũ lên máy chủ đang chạy.
Các lỗi thường gặp khi restore
- Quên
where=hoặc dùng job restore cóReplace = Always. Dữ liệu cũ đè thẳng lên máy chủ đang chạy. Kiểm hai giá trị này trước mọi lệnh restore. - Chọn
currenttheo thói quen. Khi sự cố là lỗi logic hay mã độc mã hoá dữ liệu, bản mới nhất có thể đã hỏng. Hãy tập dùngbefore=trong buổi diễn tập. - Chỉ nhìn trạng thái job restore. Job restore có thể kết thúc với cảnh báo, hoặc thành công mà không ghi file nào. Luôn đọc số file và kiểm nội dung.
- Diễn tập trên máy chủ nhỏ, suy ra cho máy chủ lớn. Thời gian restore tăng theo tổng chuỗi Incremental, không theo dung lượng máy chủ. Hãy chọn ít nhất một máy chủ thay đổi nhiều nhất để thử.
- Chỉ một người biết cách làm. Buổi diễn tập nên do người khác làm theo tài liệu, không phải người viết tài liệu.
Checklist diễn tập định kỳ
| Tần suất | Việc | Đạt khi |
|---|---|---|
| Hằng tháng | Restore vài file ngẫu nhiên từ hai, ba máy chủ khác nhau | Nội dung khớp, số file đúng |
| Hằng quý | Restore trọn một máy chủ sang máy khác, có đo giờ | Bảng băm khớp, ứng dụng khởi động được, thời gian trong mục tiêu |
| Hằng quý | Restore và nạp thử một cơ sở dữ liệu | Nạp không lỗi, số dòng và bản ghi mới nhất hợp lý |
| Sau mỗi lần sửa FileSet | Restore thử đúng phần vừa sửa | Thư mục mới có trong bản backup |
| Hằng năm | Diễn tập mất máy chủ backup: dựng lại catalog từ bản sao ngoài máy | Tra được file và restore được sau khi dựng lại |
Mỗi buổi diễn tập nên để lại một biên bản ngắn: ngày, máy chủ, JobId, số byte đọc, thời gian, lỗi gặp phải và cách xử lý. Sau vài quý, biên bản đó chính là số liệu thật về khả năng khôi phục của hệ thống, thay cho cảm giác “chắc là được”.
Không có sẵn máy chủ trống để diễn tập, Quý khách hàng có thể thuê một Cloud Server theo tháng làm restore01 rồi trả lại sau buổi diễn tập. Muốn giao việc sao lưu cho Cloudzone thay vì tự vận hành, xem Backup as a Service hoặc chat với Cloudzone.
Câu hỏi thường gặp về diễn tập khôi phục Bareos
Restore trong Bareos có ghi đè file đang chạy không?
Có thể, nếu không đặt where= hoặc job restore dùng Replace = Always (giá trị mặc định khi không khai). Khi diễn tập, luôn đặt where= tới một thư mục riêng và replace=never.
Dữ liệu restore ra nằm ở đâu khi đặt where=?
Dưới thư mục where=, kèm nguyên đường dẫn gốc. File /etc/nginx/nginx.conf restore với where=/tmp/bareos-restores sẽ nằm ở /tmp/bareos-restores/etc/nginx/nginx.conf.
Bao lâu nên diễn tập khôi phục một lần?
Theo checklist ở trên: hằng tháng restore vài file lẻ, hằng quý restore trọn một máy chủ và nạp thử một cơ sở dữ liệu, hằng năm diễn tập mất máy chủ backup, cộng một lần sau mỗi lần sửa FileSet.
Tóm tắt
- Job backup “OK” chỉ nói dữ liệu đã được ghi; chỉ restore thử mới chứng minh được nó dùng được.
- Diễn tập luôn ghi ra chỗ riêng bằng
where=vàreplace=never, nên làm trên một máy chủ khác. - Kiểm nội dung bằng bảng băm lập lúc backup; với cơ sở dữ liệu thì nạp thử và truy vấn kiểm tra.
- Thời gian restore phụ thuộc Full cộng toàn bộ Incremental sau nó; máy chủ thay đổi nhiều có thể phải đọc gấp đôi dung lượng thật.
- Tách tài khoản backup khỏi tài khoản được restore, và diễn tập theo lịch cố định.
Bài sau: Tự động hoá bconsole và những cái bẫy im lặng: những script trông đúng, chạy không lỗi, nhưng làm sai mà không ai hay.
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.