Bật nén thì đĩa backup nhẹ đi, nhưng nhẹ bao nhiêu thì chỉ dữ liệu của bạn trả lời được. Tăng số job chạy song song thì backup xong sớm hơn, cho tới khi chạm vào một giới hạn nằm đâu đó trên đường đi. Bài này nói về cả hai, và về cách tìm ra chỗ thật sự chậm.
Bài 6 tính dung lượng backup theo đỉnh, với giả định về hệ số nén. Giả định đó cần được đo, vì sai vài chục phần trăm là đủ làm cả phép tính dung lượng lệch theo. Bài này trả lời ba câu hỏi: nên dùng thuật toán nén nào, cho bao nhiêu job chạy cùng lúc, và khi backup chậm thì chậm ở khâu nào.
Nén trong Bareos xảy ra ở đâu
Nén trong Bareos là nén phần mềm, chạy trên File Daemon của máy chủ nguồn. File Daemon đọc file, nén từng block, rồi mới gửi sang Storage Daemon. Nghĩa là CPU bỏ ra để nén là CPU của máy chủ nguồn, còn mạng và đĩa backup chỉ phải chở phần đã nén.
Nén được khai trong khối Options của FileSet, không phải trong Job:
FileSet {
  Name = "web01-fs"
  Include {
    Options {
      Signature = XXH128
      Compression = LZ4
    }
    File = /var/www
    File = /etc
  }
  Exclude {
    File = /var/www/cache
  }
}
Ba đặc điểm cần nắm trước khi bật:
- Restore không cần khai gì. Cờ nén nằm trong header của từng block. File Daemon tự nhận ra và giải nén, kể cả khi một lần restore đọc lẫn volume cũ không nén và volume mới có nén.
- Nén không hồi tố. Dữ liệu đã ghi trước khi bật nén vẫn nằm nguyên như cũ. Hiệu quả chỉ đến dần, sau khi dữ liệu cũ xoay hết một vòng retention.
- Sửa FileSet thường làm job kế tiếp bị nâng lên Full. Bareos so chữ ký của FileSet; thấy đổi thì coi bản Incremental không còn đủ căn cứ. Bật nén cho cả trăm FileSet cùng lúc có thể đồng nghĩa với cả trăm bản Full cùng đêm.
Vì vậy, nếu biết chắc sẽ dùng nén, bật nó ngay từ bản Full đầu tiên. Bật sau thì vừa tốn một vòng Full, vừa phải chờ thêm một vòng retention mới thấy đĩa nhẹ đi.
LZ4 hay GZIP: đánh đổi giữa CPU và tỷ lệ nén
Bareos hỗ trợ vài thuật toán nén. Hai cái hay được cân nhắc nhất là LZ4 và GZIP:
| LZ4 | LZ4HC | GZIP (mức 1–9) | |
|---|---|---|---|
| Tỷ lệ nén | Khá | Tốt hơn LZ4 một chút | Tốt nhất trong ba |
| CPU lúc nén | Rất thấp | Cao hơn LZ4 nhiều | Cao, tăng theo mức |
| Tốc độ giải nén | Rất nhanh | Rất nhanh | Chậm hơn rõ rệt |
| Hợp với | Mặc định cho đa số máy chủ | Máy chủ nhiều CPU rảnh, dữ liệu ít đổi | Đường truyền hẹp, CPU dư dả |
Với LZ4, tốc độ nén trên một nhân CPU thường cao hơn tốc độ đọc đĩa của máy chủ nguồn. Nói cách khác, nén hiếm khi thành khâu chậm nhất. GZIP thì khác: ở mức nén cao, một job có thể bị giới hạn bởi đúng một nhân CPU, và máy chủ nguồn đang phục vụ người dùng sẽ cảm nhận được điều đó.
Một điểm thường bị bỏ qua: nén nhanh cũng làm restore nhanh. Restore thường nghẽn ở tốc độ đọc volume và truyền qua mạng. Ít byte phải đọc hơn thì restore xong sớm hơn, miễn là giải nén không chậm hơn đọc đĩa. LZ4 thoả điều kiện đó, GZIP mức cao thì không phải lúc nào cũng vậy.
Trong quá trình vận hành, đội kỹ thuật Cloudzone chọn LZ4 làm mặc định và đo được mức tiết kiệm khoảng 45% trên dữ liệu hỗn hợp. Con số đó là của dữ liệu cụ thể, không phải hằng số. Dữ liệu của bạn có thể cho kết quả khác xa.
Đo tỷ lệ nén trên dữ liệu của chính mình
Tỷ lệ nén phụ thuộc gần như hoàn toàn vào loại dữ liệu. Log và file text thường nén rất tốt. Cơ sở dữ liệu nén khá. Ảnh, video, file .zip, .gz đã nén sẵn thì gần như không giảm được gì.
Cách rẻ nhất để ước lượng trước khi bật là chạy công cụ nén dòng lệnh trên chính thư mục sẽ backup:
# Byte tho
tar -cf - /var/www /etc 2>/dev/null | wc -c

# Byte sau LZ4 (goi lz4 tren Ubuntu)
tar -cf - /var/www /etc 2>/dev/null | lz4 -1 -c | wc -c

# So sanh voi gzip muc 6
tar -cf - /var/www /etc 2>/dev/null | gzip -6 -c | wc -c
Con số này thường lạc quan hơn thực tế một chút. Công cụ dòng lệnh nén cả luồng liền mạch, còn Bareos nén theo từng block nhỏ. Hãy trừ hao một ít khi đưa vào phép tính dung lượng.
Khi đã chạy thật, đọc tỷ lệ nén ở hai chỗ. Chỗ thứ nhất là dòng Software Compression trong báo cáo cuối job. Chỗ thứ hai là catalog, ví dụ lấy dòng đó từ bảng log:
SELECT jobid, logtext
FROM log
WHERE jobid = 1234
  AND logtext LIKE '%Software Compression%';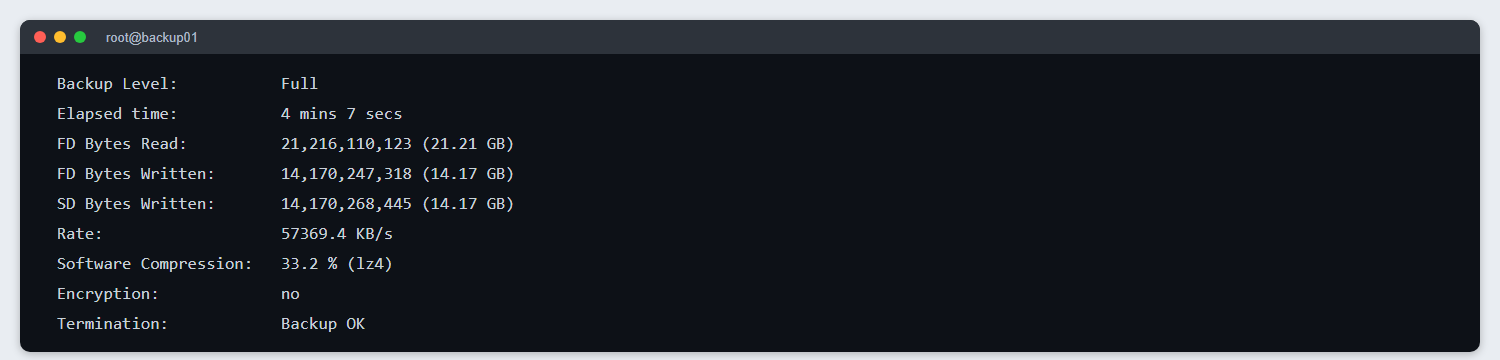
Để ý hai con số FD Bytes Read và FD Bytes Written: chênh lệch giữa chúng chính là phần LZ4 tiết kiệm được ngay tại máy chủ nguồn, trước khi dữ liệu đi qua mạng. Tỷ lệ của từng job dao động khá rộng tuỳ loại dữ liệu — job trong ảnh chỉ giảm khoảng một phần ba, nên đừng lấy một job lẻ làm con số chung.
Nếu dòng đó ra None hoặc có cảnh báo thiếu hỗ trợ LZ4, nén chưa hề chạy. Nên kiểm điều này trên một job đầu tiên, trước khi nhân cấu hình ra hàng loạt máy chủ.
Hai cái bẫy khi tổng hợp số đo cho cả hệ thống:
- Lấy trung bình theo byte, đừng lấy trung bình các tỷ lệ. Tỷ lệ chung = tổng byte sau nén chia tổng byte thô. Trung bình cộng các tỷ lệ cho một máy chủ vài GB cùng trọng số với một máy chủ vài TB, và kết quả có thể lệch xa.
- Mẫu đo phải có máy chủ lớn nhất. Tổng dung lượng thường do vài máy chủ lớn quyết định. Mẫu đo toàn máy chủ nhỏ, dễ nén, sẽ cho con số đẹp mà vô dụng.
Chạy song song: Maximum Concurrent Jobs nằm ở nhiều chỗ
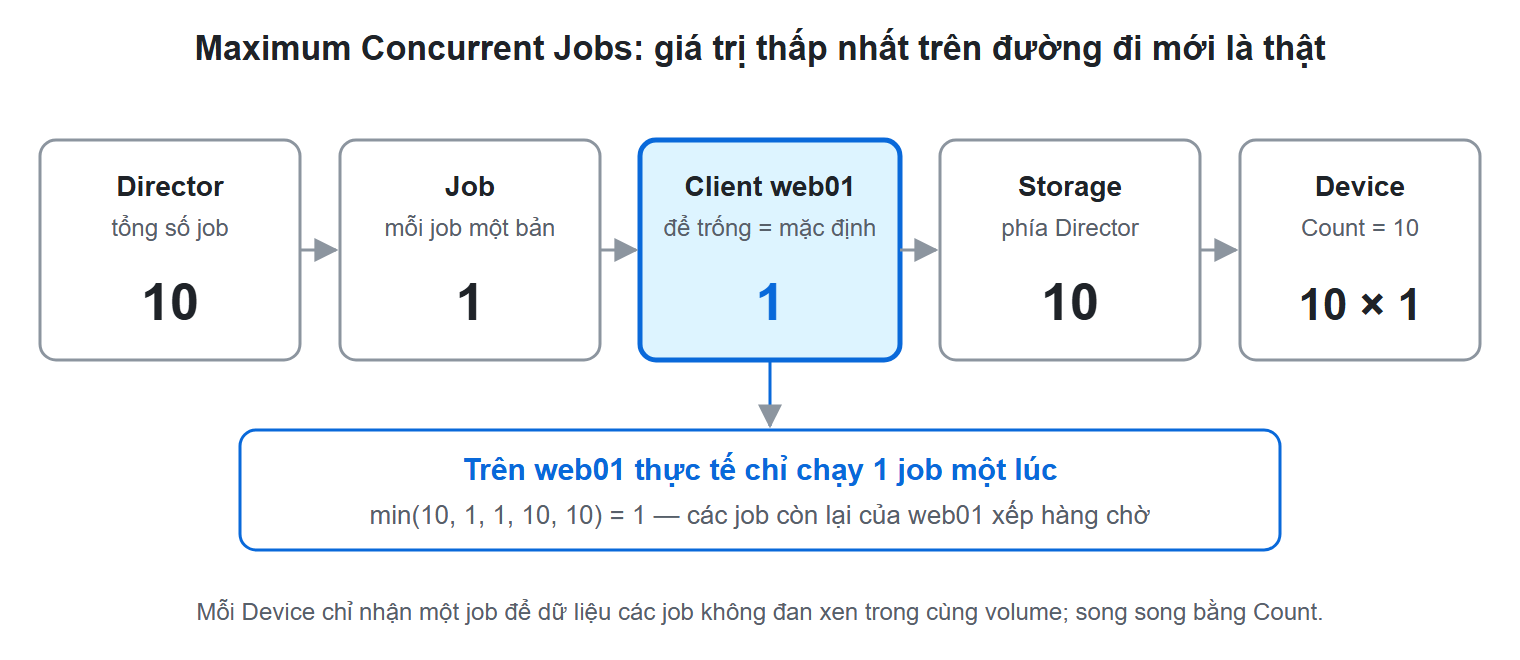
Mặc định Bareos khá dè dặt về số job chạy cùng lúc. Directive Maximum Concurrent Jobs xuất hiện ở nhiều resource, và mỗi chỗ là một cái van trên đường đi của job:
| Đặt ở đâu | File cấu hình | Giới hạn điều gì |
|---|---|---|
Resource Director | bareos-dir.d/director/ | Tổng số job Director cho chạy cùng lúc |
Resource Job | bareos-dir.d/job/ | Số bản chạy cùng lúc của chính job đó |
Resource Client (phía Director) | bareos-dir.d/client/ | Số job cùng lúc trên một máy chủ nguồn |
Resource Storage (phía Director) | bareos-dir.d/storage/ | Số job cùng lúc ghi vào một Storage |
Resource Device (phía Storage Daemon) | bareos-sd.d/device/ | Số job cùng ghi vào một thiết bị |
Quy tắc đơn giản mà hay bị quên: giá trị thấp nhất trên đường đi mới là giá trị thật. Director đặt 10, Storage đặt 10, nhưng Client để trống thì mặc định thường là 1. Mọi job của máy chủ đó sẽ xếp hàng từng cái một, dù hai chỗ kia rộng rãi đến đâu.
Một bộ cấu hình tham khảo cho máy chủ backup ghi ra đĩa:
# bareos-dir.d/director/bareos-dir.conf
Director {
  Name = bareos-dir
  Maximum Concurrent Jobs = 10
  # ...
}

# bareos-dir.d/storage/File.conf
Storage {
  Name = File
  Address = backup01.example.com
  Device = FileStorage
  Media Type = File
  Maximum Concurrent Jobs = 10
}

# bareos-dir.d/client/web01-fd.conf
Client {
  Name = web01-fd
  Address = web01.example.com
  Maximum Concurrent Jobs = 2
}

# bareos-sd.d/device/FileStorage.conf
Device {
  Name = FileStorage
  Media Type = File
  Archive Device = /var/lib/bareos/storage
  Count = 10
  Maximum Concurrent Jobs = 1
}
Chỗ đáng chú ý là Device: một device chỉ nhận một job, song song bằng cách nhân số device lên (Count). Nếu cho nhiều job ghi chung một device, dữ liệu của các job sẽ đan xen trong cùng một volume. Backup vẫn chạy, nhưng restore một máy chủ phải đọc lướt qua dữ liệu của cả những máy chủ khác, chậm đi rõ rệt.
Sau khi sửa, luôn kiểm cú pháp trước khi reload, rồi xem giá trị Director đang dùng thật:
sudo bareos-dir -t -c /etc/bareos
echo "reload" | sudo bconsole
echo "show client=web01-fd" | sudo bconsole | grep -i concurrent
Thêm một cái bẫy về thứ tự: mặc định Bareos không cho job khác Priority chạy xen nhau. Job có Priority cao hơn (số nhỏ hơn) đang chạy thì job Priority khác phải chờ. Nếu thấy job xếp hàng dù mọi van đều rộng, hãy xem Priority trước khi nghi ngờ cấu hình concurrency.
Tìm nút cổ chai: đo từng khâu một
Một job backup đi qua bốn khâu: đọc đĩa máy chủ nguồn, nén trên CPU nguồn, truyền qua mạng, ghi xuống đĩa máy chủ backup. Tốc độ job bằng tốc độ khâu chậm nhất. Tăng concurrency chỉ có ích khi khâu chậm nhất còn dư sức cho thêm luồng.
Đo đĩa máy chủ backup
Nhiều người đo bằng dd với block 1M rồi kết luận đĩa chậm. Với ổ cục bộ, cách đó thường ổn. Với ổ gắn qua mạng hoặc hệ lưu trữ phân tán, block nhỏ cho ra con số thấp giả, vì mỗi lần ghi phải chờ một vòng mạng.
Chúng tôi từng gặp đúng tình huống đó: đo block 1M một luồng chỉ được khoảng một phần ba so với block 16M một luồng. Bốn luồng song song block 16M cho tổng gấp khoảng bốn lần một luồng. Kết luận "đĩa chậm" ban đầu là sai hoàn toàn.
# Ghi mot luong, block 16M, bo qua page cache
dd if=/dev/zero of=/var/lib/bareos/storage/thu.bin bs=16M count=256 oflag=direct

# Doc lai
dd if=/var/lib/bareos/storage/thu.bin of=/dev/null bs=16M iflag=direct

# Nhieu luong song song: dung fio thay vi tu ghep dd
fio --name=ghi --directory=/var/lib/bareos/storage --rw=write --bs=16M \
    --size=4G --numjobs=4 --direct=1 --group_reporting

# Don file thu
rm -f /var/lib/bareos/storage/thu.bin /var/lib/bareos/storage/ghi.*
Nếu hệ lưu trữ bên dưới có nén hoặc khử trùng lặp, ghi toàn số 0 từ /dev/zero sẽ cho số đẹp giả. Khi đó nên thử lại bằng dữ liệu ngẫu nhiên.
Đo mạng
iperf3 giữa máy chủ nguồn và máy chủ backup cho biết đường truyền chở được bao nhiêu. Chạy một luồng rồi nhiều luồng (-P 4) để xem mạng có phải giới hạn khi nhiều job chạy cùng lúc không.
Đo tốc độ đọc ở nguồn
Khâu này hay bị bỏ qua nhất, trong khi theo kinh nghiệm của chúng tôi nó lại thường là khâu chậm nhất. Đo bằng cách đọc chính thư mục sẽ backup:
time tar -cf - /var/www | cat > /dev/nullCó một cái bẫy nhỏ ở đây: GNU tar nhận ra khi đích ghi thẳng là /dev/null và có thể bỏ qua việc đọc nội dung file. Viết tar -cf /dev/null sẽ cho con số nhanh đến vô lý. Chèn một ống | cat như trên để buộc tar đọc thật.
Máy chủ có hàng triệu file nhỏ thường chậm vì thao tác mở file, đọc metadata, không phải vì băng thông. Khi đó thêm concurrency trên cùng máy chủ ít tác dụng; chia FileSet thành vài job cho các thư mục khác nhau đôi khi giúp nhiều hơn.
So với tốc độ job thật
Báo cáo cuối job có tốc độ trung bình. Đặt nó cạnh ba số đo ở trên. Ở hệ thống của chúng tôi, tốc độ backup thực tế chỉ bằng khoảng một nửa tốc độ ghi đĩa một luồng, trong khi mạng còn dư. Khâu nghẽn nằm ở phía đọc dữ liệu nguồn. Nâng cấp đĩa máy chủ backup trong tình huống đó sẽ không giúp gì.
Bẫy và bài học vận hành
- Đo trước, quy hoạch sau. Hệ số nén trong phép tính dung lượng phải đến từ dữ liệu thật của bạn, có trọng số theo byte.
- Bản Full đầu tiên thường nén đẹp hơn các bản sau. Lần đầu thường gặp nhiều file log cũ, file rỗng, dữ liệu dễ nén. Incremental về sau chủ yếu là dữ liệu đang thay đổi, có thể nén kém hơn.
- Kiểm Maximum Concurrent Jobs ở mọi chỗ, đặc biệt là resource Client. Để trống ở đây là lỗi phổ biến nhất khiến job xếp hàng từng cái.
- Tăng concurrency có mức trần. Quá nhiều job cùng đọc một đĩa nguồn hoặc cùng ghi một hệ lưu trữ sẽ làm tổng tốc độ giảm vì đầu đọc phải nhảy qua lại. Tăng từng nấc, đo lại mỗi lần.
- Tăng tạm thời cho đợt nạp đầu. Lúc chạy Full đầu tiên cho nhiều máy chủ, có thể nâng concurrency để rút ngắn thời gian, rồi hạ lại khi vào nhịp Incremental hằng ngày.
Tóm tắt
- Nén chạy trên File Daemon của máy chủ nguồn, khai trong FileSet, không hồi tố; bật từ bản Full đầu tiên.
- LZ4 thường là lựa chọn mặc định hợp lý: CPU thấp, giải nén nhanh, restore cũng nhanh hơn. Tỷ lệ nén phải đo trên dữ liệu của chính bạn.
Maximum Concurrent Jobsnằm ở Director, Job, Client, Storage và Device; giá trị thấp nhất trên đường đi mới là thật.- Đo đĩa bằng block lớn và nhiều luồng; block nhỏ trên ổ mạng cho số thấp giả.
- Nút cổ chai thường ở phía nguồn, không phải đĩa máy chủ backup.
Bài sau: Catalog: trái tim của Bareos — vì sao mất catalog là có dữ liệu mà không biết là gì, cách bảo vệ nó, và vài câu SQL giúp trả lời nhanh "đêm qua backup ra sao".
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.