Bài 7 đã đọc tỷ lệ nén từ bảng log của catalog. Thực ra gần như mọi câu hỏi vận hành đều trả lời được từ đó: job nào lỗi, pool nào sắp đầy, volume nào sắp được tái dùng.
Catalog chứa gì
Catalog là một cơ sở dữ liệu PostgreSQL: các bản Bareos gần đây chỉ còn hỗ trợ PostgreSQL cho catalog. Director ghi vào đó mọi thứ nó biết: job đã chạy, file đã lấy, volume nào nằm trong pool nào. Vài bảng chính cần biết:
| Bảng | Mỗi dòng là | Cột hay dùng |
|---|---|---|
job | Một lần chạy job | jobid, name, type, level, jobstatus, jobbytes, jobfiles, schedtime, starttime, endtime, poolid |
pool | Một pool | poolid, name, maxvols, volretention |
media | Một volume | mediaid, volumename, poolid, volstatus, volbytes, lastwritten, volretention |
jobmedia | Một đoạn dữ liệu của job nằm trên volume | jobid, mediaid |
file, path | Một file trong một job | Tên file, đường dẫn, thuộc tính |
log | Một dòng báo cáo của job | jobid, time, logtext |
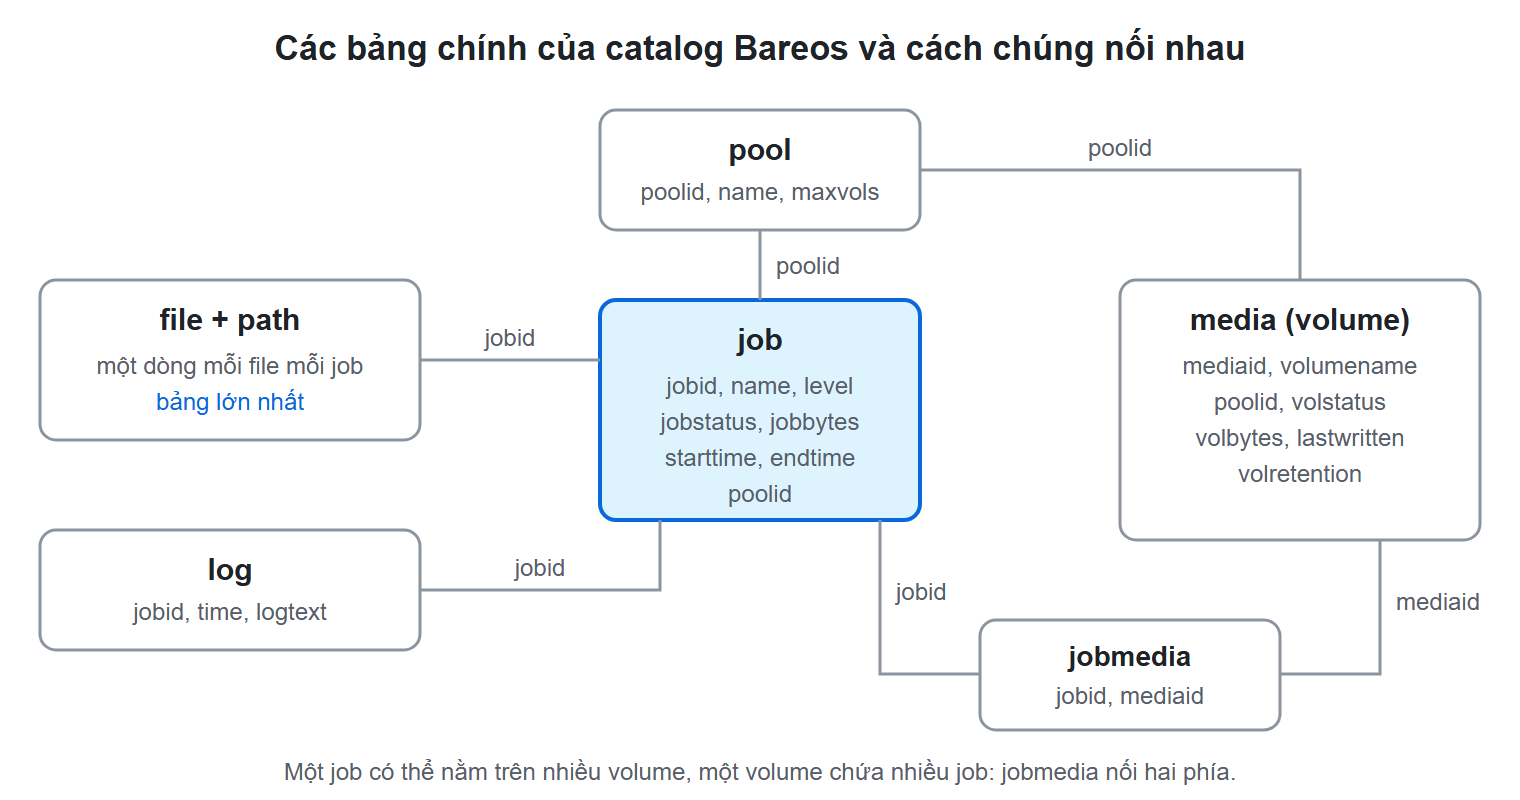
Một vài mã trạng thái sẽ gặp liên tục. Cột type: B là backup, R là restore. Cột level: F, I, D cho Full, Incremental, Differential. Cột jobstatus:
| Mã | Nghĩa |
|---|---|
T | Thành công |
W | Thành công nhưng có cảnh báo |
E, e, f | Lỗi, lỗi không nghiêm trọng, lỗi nặng |
A | Bị huỷ |
I | Dừng giữa chừng, chưa hoàn tất |
R, C | Đang chạy, đang chờ chạy |
Mất catalog thì mất gì
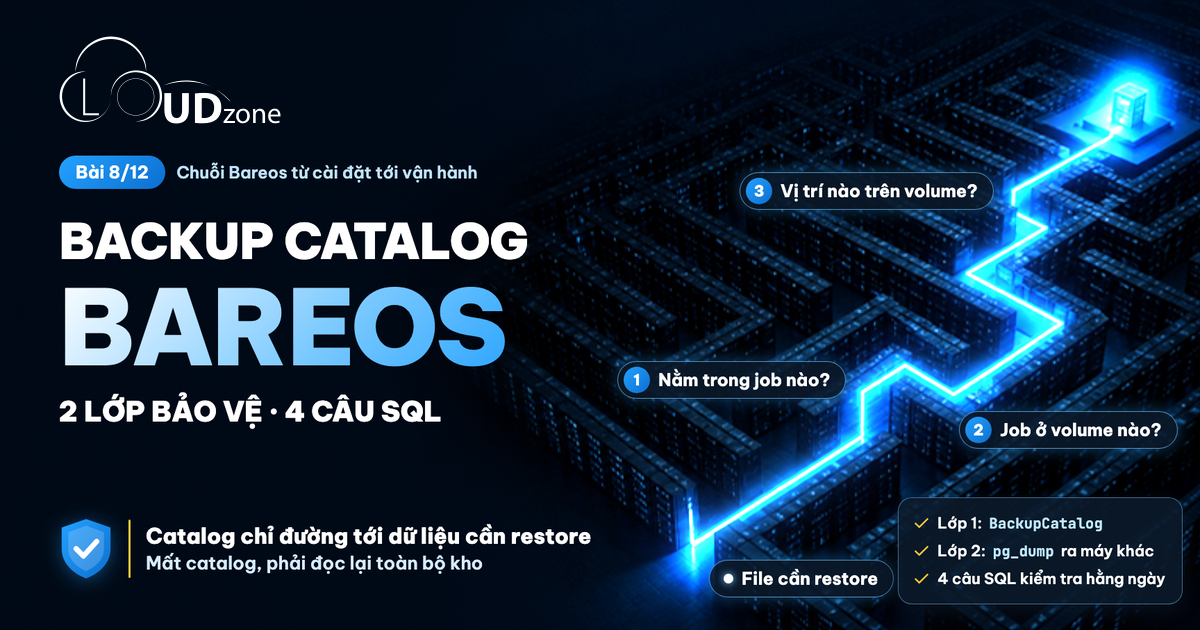
Volume trên đĩa vẫn còn nguyên. Nhưng để restore, Director cần biết file cần tìm nằm trong job nào, job đó nằm trên volume nào, ở vị trí nào. Tất cả thông tin đó nằm trong catalog.
Không có catalog, bạn còn công cụ bscan: đọc lại từng volume và dựng lại bản ghi vào catalog mới. Cách này dùng được, nhưng phải đọc toàn bộ dữ liệu trên kho. Với kho vài chục TB, riêng việc đọc có thể mất nhiều ngày, đúng lúc bạn đang cần restore gấp nhất.
Vì vậy, catalog đáng được bảo vệ ngang với chính dữ liệu backup. Nó nhỏ hơn dữ liệu rất nhiều lần, nên bảo vệ nó cũng rẻ hơn nhiều.
Bảo vệ catalog: job BackupCatalog là chưa đủ
Bareos cài sẵn một job tên BackupCatalog. Trước khi chạy, nó gọi script dump catalog ra file; sau đó backup file dump đó như một job thường; chạy xong thì xoá file dump tạm. Job này thường mang số Priority lớn hơn các job khác, tức ưu tiên thấp hơn, để chạy sau cùng trong đêm.
Điểm yếu của nó: bản backup catalog nằm trong chính kho của máy chủ backup đó. Nếu máy chủ backup hỏng đĩa hệ thống, hỏng kho, hoặc bị xoá nhầm, bạn mất cả catalog lẫn bản sao của nó cùng lúc. Nên giữ BackupCatalog chạy, nhưng coi nó là lớp thứ nhất, không phải lớp duy nhất.
Lớp thứ hai là dump định kỳ bằng pg_dump và đẩy ra khỏi máy chủ backup, kèm theo cả thư mục cấu hình:
#!/bin/bash
# /usr/local/sbin/sao-luu-catalog.sh
set -euo pipefail
DICH=/var/backups/bareos-catalog
NGAY=$(date +%F)
install -d -m 0700 "$DICH"

sudo -u postgres pg_dump -Fc bareos > "$DICH/catalog-$NGAY.dump"
tar -czf "$DICH/cauhinh-$NGAY.tar.gz" /etc/bareos

# Giu 14 ngay
find "$DICH" -name 'catalog-*.dump' -mtime +14 -delete
find "$DICH" -name 'cauhinh-*.tar.gz' -mtime +14 -delete

# Day ra may chu khac
rsync -a "$DICH/" saoluu@backup02.example.com:/srv/bareos-catalog/
Đích đẩy ra có thể là một máy chủ khác hoặc kho Object Storage chuẩn S3; cách đẩy bằng rclone có ở bài Sao lưu máy chủ lên Object Storage bằng rclone.
Chạy nó bằng systemd timer, ví dụ mỗi sáng sau khi các job đêm đã xong:
# /etc/systemd/system/sao-luu-catalog.service
[Unit]
Description=Sao luu catalog Bareos

[Service]
Type=oneshot
ExecStart=/usr/local/sbin/sao-luu-catalog.sh

# /etc/systemd/system/sao-luu-catalog.timer
[Timer]
OnCalendar=*-*-* 05:00
Persistent=true

[Install]
WantedBy=timers.target
Sau đó nạp lại systemd và bật timer:
sudo systemctl daemon-reload && sudo systemctl enable --now sao-luu-catalog.timerBản dump chứa danh sách máy chủ, đường dẫn và tên file của cả hệ thống. Thư mục /etc/bareos còn chứa mật khẩu của Director, Storage và từng Client, nên bản nén cấu hình cũng phải giữ kín như bản dump. Hãy bảo vệ nó như dữ liệu nhạy cảm: quyền 0700, tài khoản đích chỉ được ghi vào đúng một thư mục.
Cuối cùng, có file dump chưa có nghĩa là khôi phục được. Thỉnh thoảng hãy thử nạp nó vào một cơ sở dữ liệu tạm:
sudo -u postgres createdb thu_khoi_phuc
sudo -u postgres pg_restore -d thu_khoi_phuc /var/backups/bareos-catalog/catalog-2026-01-15.dump
sudo -u postgres psql -d thu_khoi_phuc -c "SELECT count(*), max(jobid) FROM job"
sudo -u postgres dropdb thu_khoi_phuc
Lỗi này hay gặp ở hệ thống chạy lâu: máy chủ backup chạy đều đặn, nhưng bản dump catalog duy nhất lại nằm ngay trên chính máy đó. Nó chỉ lộ ra khi rà lại từng lớp.
Kích thước catalog tỷ lệ với số file, không phải số byte
Bảng file có một dòng cho mỗi file trong mỗi job. Một máy chủ chứa một file cơ sở dữ liệu 500 GB chỉ tốn một dòng. Một máy chủ web chứa hai triệu file ảnh nhỏ tốn hai triệu dòng cho mỗi bản Full, cộng thêm số file thay đổi của mỗi bản Incremental.
Nên khi ước lượng catalog, hãy đếm file, đừng đếm TB. Xem bảng nào đang lớn:
SELECT relname,
       pg_size_pretty(pg_total_relation_size(relid)) AS kich_thuoc,
       n_live_tup AS so_dong
FROM pg_stat_user_tables
ORDER BY pg_total_relation_size(relid) DESC
LIMIT 5;
Nếu bảng file phình quá nhanh, hãy xem lại retention của bản ghi file. Khi bản ghi file đã bị dọn, job vẫn restore được nguyên khối, nhưng không còn chọn được từng file lẻ qua giao diện. Đây là đánh đổi, không phải lỗi.
Truy vấn catalog: người dùng chỉ-đọc và ba cái bẫy
Tạo người dùng chỉ-đọc cho báo cáo
Script báo cáo, dashboard hay công cụ giám sát không nên dùng tài khoản bareos của Director. Một câu UPDATE viết nhầm là đủ làm hỏng catalog. Tạo tài khoản riêng chỉ có quyền đọc:
CREATE ROLE bao_cao_ro LOGIN;
\password bao_cao_ro
GRANT CONNECT ON DATABASE bareos TO bao_cao_ro;
GRANT USAGE ON SCHEMA public TO bao_cao_ro;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO bao_cao_ro;
ALTER DEFAULT PRIVILEGES FOR ROLE bareos IN SCHEMA public
  GRANT SELECT ON TABLES TO bao_cao_ro;
Dòng cuối để bảng Bareos tạo thêm khi nâng cấp cũng tự có quyền đọc. Trong pg_hba.conf, chỉ mở cho đúng nguồn cần đọc, ví dụ chỉ trên máy chủ backup:
host bareos bao_cao_ro 127.0.0.1/32 scram-sha-256Bẫy một: thời gian không múi giờ và extract(epoch)
Các cột starttime, endtime, schedtime, lastwritten có kiểu timestamp không múi giờ. Director ghi vào đó giờ địa phương, ví dụ giờ Việt Nam.
Hàm extract(epoch FROM ...) trên kiểu này luôn coi giá trị là giờ UTC, bất kể cơ sở dữ liệu đặt múi giờ nào. Đổi epoch đó ngược ra giờ thật sẽ lệch đúng bằng độ lệch múi giờ, ở Việt Nam là 7 tiếng:
-- sai: lech 7 tieng o Viet Nam
SELECT to_timestamp(extract(epoch FROM starttime)) FROM job WHERE jobid = 1234;

-- dung: in thang gia tri da luu
SELECT to_char(starttime, 'YYYY-MM-DD HH24:MI:SS') FROM job WHERE jobid = 1234;
Hiệu của hai epoch vẫn đúng, vì hai bên lệch cùng một lượng. Nên extract(epoch FROM endtime - starttime) để tính thời lượng job là an toàn. Chỉ khi cần giờ thật mới phải tránh.
Bẫy hai: ký tự ngoài ASCII trong câu SQL
Catalog Bareos thường được tạo với encoding SQL_ASCII. Một số thư viện, ví dụ psycopg của Python, khi đó mã hoá câu lệnh bằng bảng mã ASCII. Chỉ cần một chữ tiếng Việt có dấu trong câu SQL, kể cả trong dòng chú thích, là cả câu lệnh lỗi trước khi tới được máy chủ.
Cách tránh: giữ câu SQL gửi tới catalog hoàn toàn ASCII, đặt chú thích tiếng Việt ở phía code. Các ví dụ trong bài này cố ý viết chú thích không dấu vì lý do đó.
Bẫy ba: đếm và nối bảng
- Nối
jobmediasinh dòng lặp. Một job ghi nhiều đoạn vào cùng một volume thì có nhiều dòngjobmedia. Muốn danh sách volume của một job phải dùngDISTINCT. - Đếm volume dùng
count(m.mediaid), không dùngcount(*). KhiLEFT JOINpool với media, pool rỗng vẫn sinh một dòng toàn NULL;count(*)sẽ đếm nó thành một volume. - Chuỗi có thể về dạng bytes. Vì catalog dùng encoding
SQL_ASCII, một số thư viện (ví dụ psycopg bản 3) trả mọi cột chữ, kể cảjobstatusvàlevel, về dạng bytes thay vì chuỗi. So sánh với'T'trong code sẽ luôn sai nếu chưa giải mã.
Bốn câu SQL hữu ích
Máy chủ nào đang lỗi, tính theo lần chạy gần nhất
Một job lỗi lúc 21:00 rồi tự chạy lại thành công lúc 23:00 thì không cần ai thức dậy. Vì vậy nên xét lần chạy gần nhất của mỗi job, không phải mọi dòng lỗi trong 24 giờ:
SELECT name, jobid, level, jobstatus,
       to_char(starttime, 'YYYY-MM-DD HH24:MI') AS bat_dau
FROM (
    SELECT DISTINCT ON (name) name, jobid, level, jobstatus, starttime
    FROM job
    WHERE type = 'B'
      AND schedtime > now() - interval '24 hours'
    ORDER BY name, jobid DESC
) gan_nhat
WHERE jobstatus IN ('E', 'e', 'f', 'A', 'I')
ORDER BY name;
Sắp theo jobid thay vì starttime: job bị huỷ trước khi kịp chạy có starttime rỗng, và PostgreSQL xếp giá trị rỗng lên đầu khi sắp giảm dần.
Dung lượng và số volume theo pool
SELECT p.name AS pool,
       count(m.mediaid) AS so_volume,
       p.maxvols AS tran,
       pg_size_pretty(COALESCE(sum(m.volbytes), 0)) AS dung_luong,
       count(m.mediaid) FILTER (WHERE m.volstatus = 'Append') AS dang_ghi,
       count(m.mediaid) FILTER (WHERE m.volstatus IN ('Full', 'Used')) AS da_day,
       count(m.mediaid) FILTER (WHERE m.volstatus IN ('Purged', 'Recycle')) AS tai_dung_duoc
FROM pool p
LEFT JOIN media m ON m.poolid = p.poolid
GROUP BY p.poolid, p.name, p.maxvols
ORDER BY COALESCE(sum(m.volbytes), 0) DESC;
Khi so_volume tiến gần tran mà tai_dung_duoc bằng 0, pool sắp hết chỗ ghi. Job sẽ đứng chờ với thông báo không tìm được volume để ghi.
Volume sắp hết hạn giữ
SELECT m.volumename, p.name AS pool, m.volstatus,
       to_char(m.lastwritten, 'YYYY-MM-DD HH24:MI') AS ghi_lan_cuoi,
       to_char(m.lastwritten + m.volretention * interval '1 second',
               'YYYY-MM-DD HH24:MI') AS het_han,
       pg_size_pretty(m.volbytes) AS dung_luong
FROM media m
JOIN pool p ON p.poolid = m.poolid
WHERE m.volstatus IN ('Full', 'Used')
  AND m.lastwritten + m.volretention * interval '1 second'
      < now() + interval '3 days'
ORDER BY m.lastwritten;
Dùng m.volretention của từng volume, đừng dùng p.volretention của pool. Mỗi volume mang theo hạn giữ từ lúc được tạo. Nếu bạn đổi retention của pool sau đó, volume cũ vẫn giữ giá trị cũ, và hai con số có thể khác nhau.
Volume đã quá hạn vẫn có thể còn trạng thái Full hay Used. Bareos dọn theo kiểu lười: chỉ prune khi cần một volume mới để ghi. Đừng cộng thẳng dung lượng các volume này vào phần "đã dùng" khi ước lượng chỗ trống.
Máy chủ quá 25 giờ chưa có bản thành công
SELECT name,
       to_char(max(endtime), 'YYYY-MM-DD HH24:MI') AS thanh_cong_gan_nhat
FROM job
WHERE type = 'B'
  AND jobstatus IN ('T', 'W')
GROUP BY name
HAVING max(endtime) < now() - interval '25 hours'
ORDER BY max(endtime);
Câu này bắt được job im lặng: không lỗi, chỉ đơn giản là không chạy. Với lịch chạy mỗi ngày, 25 giờ là đủ một chu kỳ cộng biên cho job chạy lâu. Nó có hai điểm mù. Job chưa từng thành công lần nào sẽ không xuất hiện. Job đã gỡ khỏi cấu hình vẫn xuất hiện mãi. Hãy đối chiếu với danh sách job đang cấu hình trước khi báo động.
Các câu so với now() chỉ đúng khi múi giờ phiên PostgreSQL khớp với múi giờ Director ghi vào catalog. Đây chính là bẫy múi giờ đã nói ở bài 2.
Tóm tắt
- Catalog cho biết cái gì nằm ở đâu; mất nó thì chỉ còn
bscan, chậm đúng lúc cần nhanh nhất. - Giữ
BackupCatalog, nhưng thêmpg_dumpđịnh kỳ đẩy ra máy chủ khác, kèm/etc/bareos, và thử khôi phục bản dump. - Kích thước catalog tỷ lệ với số file, không phải số byte.
- Báo cáo dùng tài khoản chỉ-đọc; tránh
extract(epoch)khi cần giờ thật, giữ câu SQL toàn ASCII. - Xét lần chạy gần nhất của mỗi job, và dùng hạn giữ của từng volume thay vì của pool.
Cần một kho ngoài máy để giữ bản dump catalog, mời Quý khách hàng chat với Cloudzone.
Bài sau: Diễn tập khôi phục Bareos: một kịch bản diễn tập trên máy chủ Linux, từ file lẻ tới cơ sở dữ liệu, kèm checklist chạy định kỳ.
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.