Hỏi "kho backup cần bao nhiêu đĩa", câu trả lời hay gặp là một phép nhân: dung lượng một bản Full, nhân hệ số, cộng phần Incremental trung bình. Con số đó thường đúng cho mức trung bình và sai đúng vào lúc quan trọng nhất: lúc kho đầy nhất.
Bài 5 kết luận rằng khi không truncate, đĩa sẽ phình tới đúng mức Maximum Volumes × Maximum Volume Bytes. Vậy trần đó đặt bao nhiêu là đủ? Bài này chỉ ra hai chỗ công thức quen thuộc hay sai, rồi thay nó bằng một đoạn mô phỏng từng ngày chừng ba chục dòng Python.
Công thức quen thuộc
Giả sử lịch backup là Full đầu mỗi tháng, Incremental các ngày còn lại. Pool Full giữ 45 ngày, pool Incremental giữ 30 ngày, như cấu hình ở bài 5. Cách ước lượng hay gặp:
dung lượng ≈ 1,5 × (một bản Full) + 30 ngày × (một bản Full) × (tỷ lệ thay đổi mỗi ngày)Lập luận nghe hợp lý: Full giữ 45 ngày mà chu kỳ 30 ngày, nên "trung bình" có 1,5 bản. Tỷ lệ thay đổi lấy bằng mức điển hình, tức trung vị của các máy chủ. Cả hai bước đều có vấn đề.
Sai thứ nhất: kho phải chứa được đỉnh, không phải trung bình
Theo dõi một máy chủ qua hai chu kỳ:
| Ngày | Việc xảy ra | Số bản Full đang sống |
|---|---|---|
| 1 | Full #1 được ghi | 1 |
| 31 | Full #2 được ghi, Full #1 chưa hết hạn | 2 |
| 46 | Full #1 hết 45 ngày, volume được tái dùng | 1 |
| 61 | Full #3 được ghi, Full #2 chưa hết hạn | 2 |
Trung bình đúng là 1,5 bản. Nhưng trong khoảng ngày 31 đến 45 của mỗi chu kỳ, không volume Full nào được phép tái dùng. Pool phải chứa trọn hai bản. Nếu trần chỉ đủ cho 1,5 bản, job Full #2 sẽ đứng chờ volume đúng vào tuần đó.
Quy tắc nhanh: số bản Full cùng sống ở đỉnh bằng retention Full chia chu kỳ Full, làm tròn lên. Retention 45 ngày, chu kỳ 30 ngày cho ra 2 bản. Nếu hai số chia hết cho nhau (vd 30 và 30), đỉnh thường vẫn cao hơn một bản vài ngày, vì Full ghi trải nhiều đêm và volume sống theo lần ghi cuối.
Muốn giảm số bản Full ở đỉnh chỉ có hai cách: hạ retention Full, hoặc kéo dài chu kỳ Full. Cả hai đều trả giá bằng cửa sổ khôi phục hoặc chuỗi Incremental dài hơn. Đây là ràng buộc số học, không phải hạn chế riêng của Bareos.
Sai thứ hai: tổng byte do tổng thay đổi quyết định, không do trung vị
Tỷ lệ thay đổi mỗi ngày (churn) giữa các máy chủ lệch nhau rất xa. Phần lớn máy chủ web hay máy chủ ứng dụng chỉ đổi 1–2% dữ liệu mỗi ngày. Một vài máy chủ cơ sở dữ liệu, máy chủ log hay máy chủ build có thể đổi 20% hoặc hơn.
Trung vị mô tả đúng "máy chủ điển hình". Nhưng dung lượng pool Incremental là tổng byte, và tổng byte bị vài máy chủ churn lớn chi phối. Công thức đúng cho tổng:
churn tổng = Σ (cỡ máy chủ × churn máy chủ) / Σ cỡ máy chủTrong ví dụ bên dưới, 37 máy chủ đổi 1,5% mỗi ngày và ba máy chủ đổi 20%. Trung vị là 1,5%, còn churn tổng là khoảng 4,1%, gần gấp ba. Riêng ba máy chủ đó tạo ra khoảng 68% byte Incremental.
Bài 4 từng cảnh báo outlier làm sai trung bình. Cần phân biệt hai loại. Một job đột biến một lần (chạy lại toàn bộ sau sự cố) thì nên loại khi đánh giá xu hướng. Một máy chủ churn lớn đều đặn mỗi ngày thì không phải nhiễu: đó là byte thật, phải nằm trong phép tính dung lượng.
Mô phỏng từng ngày thay cho công thức
Thay vì ghép công thức, hãy để máy tính đếm. Ý tưởng rất đơn giản: mỗi ngày, mỗi máy chủ ghi ra một "khúc" dữ liệu (Full hoặc Incremental). Khúc đó sống đúng bằng retention của pool chứa nó. Dung lượng sống của ngày n là tổng mọi khúc còn sống vào ngày đó.
Đoạn Python dưới đây dùng số giả định: 40 máy chủ, Full đã nén 200 GB mỗi máy chủ, riêng ba máy chủ cỡ 400 GB có churn cao. Full trải đều trên năm đêm đầu chu kỳ để không dồn tải vào một đêm. Không cần thư viện ngoài:
# Mô phỏng dung lượng sống của hai pool Bareos theo từng ngày (số giả định)
import statistics

# (cỡ Full đã nén GB, tỷ lệ thay đổi mỗi ngày) cho từng máy chủ
MAY_CHU = [(200, 0.015)] * 37 + [(400, 0.20)] * 3
CHU_KY_FULL = 30        # Full đầu mỗi chu kỳ 30 ngày
TRAI_FULL = 5           # Full trải đều trên 5 ngày đầu chu kỳ
GIU_FULL, GIU_INCR = 45, 30   # Volume Retention của hai pool (ngày)
SO_NGAY = 180

ghi = []  # (ngày ghi, số GB, pool)
for i, (co, churn) in enumerate(MAY_CHU):
    lech = i % TRAI_FULL
    for ngay in range(SO_NGAY):
        if (ngay - lech) % CHU_KY_FULL == 0:
            ghi.append((ngay, co, "full"))
        elif ngay > lech:                       # chỉ Incremental sau Full đầu tiên
            ghi.append((ngay, co * churn, "incr"))

def song(ngay, pool, giu):
    return sum(gb for d, gb, p in ghi if p == pool and d <= ngay < d + giu)

full = [song(n, "full", GIU_FULL) for n in range(SO_NGAY)]
incr = [song(n, "incr", GIU_INCR) for n in range(SO_NGAY)]
tong = [f + i for f, i in zip(full, incr)]
on_dinh = tong[60:]                             # bỏ giai đoạn khởi động

mot_full = sum(co for co, _ in MAY_CHU)
trung_vi = statistics.median(c for _, c in MAY_CHU)
churn_tong = sum(co * c for co, c in MAY_CHU) / mot_full
uoc_tinh = 1.5 * mot_full + GIU_INCR * mot_full * trung_vi
print(f"Một bản Full: {mot_full:,.0f} GB | churn trung vị {trung_vi:.1%}, "
      f"churn tổng {churn_tong:.2%}")
print(f"Ước tính kiểu '1,5 bản': {uoc_tinh:,.0f} GB (dùng churn tổng: "
      f"{1.5 * mot_full + GIU_INCR * mot_full * churn_tong:,.0f} GB)")
print(f"Mô phỏng: trung bình {statistics.mean(on_dinh):,.0f} | "
      f"thấp nhất {min(on_dinh):,.0f} | ĐỈNH {max(on_dinh):,.0f} GB "
      f"(ngày {60 + on_dinh.index(max(on_dinh))})")
print(f"Ước tính thiếu so với đỉnh: {1 - uoc_tinh / max(on_dinh):.0%}")
print(f"Trần pool Full: {max(full[60:]) * 1.1:,.0f} GB, Incr: {max(incr[60:]) * 1.1:,.0f} GB")
Kết quả khi chạy:
Một bản Full: 8,600 GB | churn trung vị 1.5%, churn tổng 4.08%
Ước tính kiểu '1,5 bản': 16,770 GB (dùng churn tổng: 23,430 GB)
Mô phỏng: trung bình 23,079 | thấp nhất 18,779 | ĐỈNH 27,379 GB (ngày 64)
Ước tính thiếu so với đỉnh: 39%
Trần pool Full: 18,920 GB, Incr: 11,197 GB
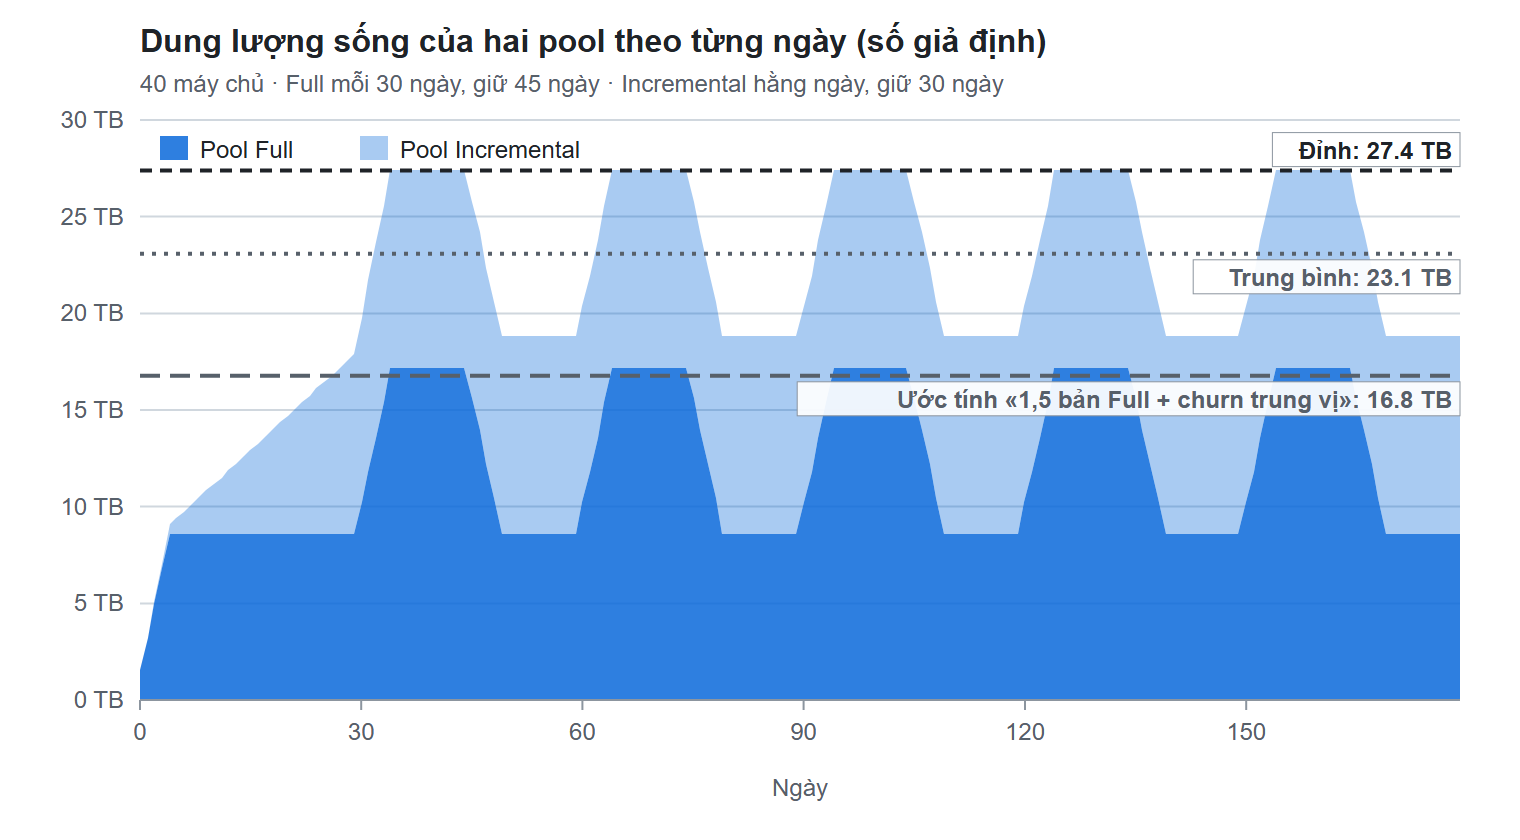
Biểu đồ dưới đây vẽ từ chính các mảng full và incr của đoạn mô phỏng:
Đọc kết quả
| Cách tính | Kết quả | So với đỉnh thật |
|---|---|---|
| 1,5 bản Full + churn trung vị | 16,8 TB | thiếu khoảng 39% |
| 1,5 bản Full + churn tổng | 23,4 TB | thiếu khoảng 14%, gần bằng mức trung bình |
| Mô phỏng: trung bình | 23,1 TB | thiếu khoảng 16% |
| Mô phỏng: đỉnh | 27,4 TB | — |
Ba điều đáng chú ý:
- Hai lỗi cộng dồn. Sửa riêng churn thì công thức cho ra đúng mức trung bình. Phải sửa thêm phần "2 bản Full" mới chạm được đỉnh.
- Đỉnh kéo dài chứ không thoáng qua. Từ lúc Full mới ghi xong (đêm thứ năm của chu kỳ) tới khi Full cũ đầu tiên hết hạn là khoảng 11 ngày, tức hơn một phần ba thời gian.
- Tháng đầu đánh lừa. Trong 30 ngày đầu kho chỉ có một bản Full, biểu đồ trông rất rộng. Đỉnh thật đầu tiên chỉ đến ở chu kỳ thứ hai, dù không có máy chủ nào mới.
Với số giả định này, công thức quen thuộc báo thiếu gần 40%. Trên dữ liệu thật mà chúng tôi từng đối chiếu, mức báo thiếu vào khoảng 30%. Con số cụ thể tuỳ hệ thống, nhưng chiều sai thì luôn là báo thiếu.
Từ đỉnh ra cấu hình pool
Có đỉnh của từng pool, việc còn lại là quy đổi ra directive:
- Trần pool = đỉnh × 1,1. Mười phần trăm dự phòng phủ những thứ mô phỏng bỏ qua: volume sống theo job ghi muộn nhất trên nó, vài job chạy lại, dao động churn giữa các tuần.
Maximum Volumes= trần pool ÷Maximum Volume Bytes, làm tròn lên. Pool Full: 18.920 GB ÷ 100 GB ≈ 190 volume. Pool Incremental: 11.197 GB ÷ 50 GB ≈ 224 volume. Đó chính là hai con số trong cấu hình mẫu ở bài 5.- Đĩa vật lý = tổng trần các pool, chừa thêm khoảng trống cho hệ thống file. Nếu muốn giữ đĩa dưới khoảng 88% đầy: (18,9 + 11,2) ÷ 0,88 ≈ 34,2 TB.
- Cộng tăng trưởng. Dữ liệu tăng đều mỗi tháng thì đỉnh sau vài tháng cũng tăng theo. Tính trần cho mốc bạn định mở rộng đĩa lần tới, không phải cho hôm nay.
# Đặt trần theo đỉnh mô phỏng, rồi nạp vào catalog
Pool {
  Name = full-45d
  Volume Retention = 45 days
  Maximum Volume Bytes = 100G
  Maximum Volumes = 190      # 18.920 GB / 100 GB
  ...
}

# sau khi sửa file: kiểm cú pháp, reload, cập nhật bản ghi pool
bareos-dir -t
echo "reload" | bconsole
echo "update pool=full-45d" | bconsole
Lưu ý: bconsole có thể thoát mã 0 kể cả khi không nối được Director, nên đọc output chứ đừng tin mã thoát. Bài 10 nói kỹ chuyện này.
Bẫy và bài học vận hành
Hai tham số nhạy nhất thường chưa đo được
Đoạn mô phỏng chỉ tốt bằng hai tham số đầu vào: tỷ lệ nén (cỡ Full sau nén so với dữ liệu gốc) và churn tổng. Trước khi chạy thật, cả hai thường chỉ là ước đoán. Đổi churn tổng từ 4% lên 6% là pool Incremental tăng khoảng một nửa.
Cách giảm rủi ro rẻ nhất là đo thật trước đỉnh đầu tiên. Bản Full đầu tiên cho số đo tỷ lệ nén. Vài tuần Incremental đầu cho số đo churn tổng. Cả hai có trước ngày 31, tức trước khi hai bản Full chồng lên nhau. Chạy lại mô phỏng với số thật, rồi chỉnh trần.
Nới trần thì dễ, nới đĩa thì phải có sẵn
Đổi Maximum Volumes chỉ là sửa file và reload, không đụng tới dữ liệu. Đĩa vật lý thì khác: phải có chỗ trước khi pool cần. Vì vậy nên cấp đĩa theo con số thận trọng, đặt trần theo con số cơ sở, rồi nới trần khi số đo thật cho phép.
Ngược lại, mỗi lần mở rộng đĩa phải nới Maximum Volumes theo. Quên bước này thì đĩa còn trống mà job vẫn đứng chờ volume.
So le ngày Full giảm tải, không giảm đỉnh
Trải Full ra nhiều đêm giúp mạng và đĩa không bị dồn vào một đêm. Nhưng nó không làm giảm đỉnh dung lượng: ở ngày cao nhất, pool Full vẫn chứa đủ hai bản của mọi máy chủ. Đừng tính nhầm lợi ích của so le vào bài toán dung lượng.
Trung bình của hệ thống, không phải của từng máy chủ
Khi báo cáo, đừng chỉ nhìn "máy chủ điển hình". Hãy liệt kê năm máy chủ có tổng byte Incremental lớn nhất trong 30 ngày. Thường chính danh sách này quyết định pool Incremental, và cũng là nơi đáng xem lại FileSet nhất: thư mục cache, file log xoay vòng, bản dump cơ sở dữ liệu tạo lại mỗi đêm.
Tóm tắt
- Kho backup phải chứa được đỉnh. Retention Full dài hơn chu kỳ Full nghĩa là có những ngày hai bản Full cùng sống.
- Tổng byte Incremental do churn tổng quyết định. Vài máy chủ churn lớn thường chiếm phần lớn, trung vị che mất chúng.
- Mô phỏng từng ngày, mỗi khúc dữ liệu sống đúng retention của pool, đáng tin hơn mọi công thức trung bình.
- Trần pool = đỉnh × 1,1, quy ra
Maximum Volumes. Đĩa vật lý cộng thêm khoảng trống cho hệ thống file và tăng trưởng. - Đo tỷ lệ nén và churn thật trước đỉnh đầu tiên, rồi chỉnh lại trần.
Bài sau: Nén, chạy song song và tìm nút cổ chai — LZ4 hay GZIP, Maximum Concurrent Jobs ở bốn chỗ khác nhau, và vì sao phép đo đĩa đầu tiên thường cho số thấp giả.
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.