Đặt retention 30 ngày, vài tháng sau đĩa backup vẫn đầy dần như chưa từng xoá gì. Lý do thường không nằm ở con số retention, mà ở chỗ Bareos xoá theo đơn vị nào, xoá lúc nào, và xoá xong thì đĩa có được trả lại hay không.
Bài 4 đã chọn cách chia Full và Incremental. Bài này trả lời câu hỏi tiếp theo: bản cũ bao giờ mới thật sự biến mất khỏi đĩa? Chúng ta sẽ đi qua ba loại retention, bốn thao tác dọn dẹp dễ nhầm với nhau, và một loại rác mà Bareos không tự dọn.
Ba loại retention, và cái nào thật sự quyết định đĩa
Bareos có ba đồng hồ retention. Chúng đặt ở những chỗ khác nhau và dọn những thứ khác nhau:
| Directive | Đặt ở đâu | Hết hạn thì dọn gì | Trả lại đĩa? |
|---|---|---|---|
File Retention | Client (Pool có thể ghi đè) | Danh sách từng file của job trong catalog. Hết hạn thì không chọn được file lẻ khi restore nữa | Không |
Job Retention | Client (Pool có thể ghi đè) | Bản ghi job trong catalog | Không trực tiếp |
Volume Retention | Pool | Cả một volume: mọi job trên đó bị xoá khỏi catalog, volume được phép dùng lại | Có thể, tuỳ cấu hình |
Điểm mấu chốt: dữ liệu nằm trong volume, nên đĩa chỉ được giải phóng theo từng volume. File Retention và Job Retention chỉ làm gọn catalog. Nhiều hệ thống đặt hai giá trị này rất dài (vài năm) để catalog không tự quên gì, khi đó thứ duy nhất quyết định dung lượng là Volume Retention trên pool.
Có hai chi tiết hay bị bỏ qua:
- Volume Retention tính từ lần ghi cuối vào volume (cột
LastWrittentrong catalog), không tính từ lúc job bắt đầu. Một volume chứa job của ba đêm liên tiếp sẽ sống theo đêm muộn nhất. - Job Retention ngắn hơn chu kỳ Full là nguy hiểm. Khi bản ghi của bản Full gần nhất bị dọn khỏi catalog, Incremental tiếp theo không tìm thấy mốc và thường tự nâng lên Full. Đĩa đột nhiên tăng mà lịch không đổi gì.
Một pool, một retention: vì sao nên tách pool theo level
Retention nằm trên pool, và mỗi pool chỉ có một giá trị. Muốn bản Full giữ lâu hơn Incremental thì bắt buộc phải có hai pool. Job chọn pool theo level bằng các directive Full Backup Pool, Incremental Backup Pool, Differential Backup Pool:
# /etc/bareos/bareos-dir.d/pool/full-45d.conf
Pool {
  Name = full-45d
  Pool Type = Backup
  Recycle = yes
  AutoPrune = yes
  Volume Retention = 45 days
  Maximum Volume Bytes = 100G
  Maximum Volumes = 190
  Label Format = "full-45d-"
}

# /etc/bareos/bareos-dir.d/pool/incr-30d.conf
Pool {
  Name = incr-30d
  Pool Type = Backup
  Recycle = yes
  AutoPrune = yes
  Volume Retention = 30 days
  Maximum Volume Bytes = 50G
  Maximum Volumes = 224
  Label Format = "incr-30d-"
}

# /etc/bareos/bareos-dir.d/jobdefs/linux-thang.conf
JobDefs {
  Name = linux-thang
  Type = Backup
  Pool = full-45d
  Full Backup Pool = full-45d
  Incremental Backup Pool = incr-30d
  Schedule = full-dau-thang
  Storage = File
  Messages = Standard
}
Hai pool cũng có lợi phụ: volume Full và volume Incremental không trộn lẫn, nên khi một nhóm hết hạn thì cả volume sạch cùng lúc. Nếu để chung một pool, Bareos thường vẫn tự tách phần lớn, vì mỗi đêm chỉ ghi một loại level. Nhưng chỉ cần vài volume trộn là vài volume đó phải chờ job muộn nhất trên chúng.
Con số 45/30 thật sự mua được gì
Muốn restore về một mốc Incremental, Bareos cần bản Full đứng trước và toàn bộ Incremental từ Full tới mốc đó. Vì vậy một mốc chết theo mắt xích đầu chuỗi, không theo đồng hồ của chính nó.
Với Full mỗi tháng, giữ 45 ngày, Incremental giữ 30 ngày, tại mọi thời điểm bạn thường có:
- toàn bộ chuỗi của chu kỳ hiện tại (mọi mốc từ bản Full gần nhất);
- bản Full của chu kỳ trước, khôi phục được về đúng ngày đó.
Tức là "giữ 30 ngày" không có nghĩa "mốc nào cũng khôi phục được đủ 30 ngày". Ba mươi ngày là tuổi thọ của volume, không phải tuổi thọ của khả năng khôi phục từng mốc. Muốn mọi mốc sống đủ một khoảng W thì retention phải cộng thêm độ dài chuỗi, và cái giá là đĩa (bài 6 tính cụ thể).
Prune, purge, recycle, truncate: bốn từ dễ nhầm
Đây là chỗ hầu hết hiểu lầm về dung lượng bắt đầu. Bốn thao tác này làm bốn việc khác nhau:
| Thao tác | Làm gì | Tôn trọng retention? | Đĩa giảm? |
|---|---|---|---|
prune | Xoá khỏi catalog các bản ghi job/file đã quá hạn. Volume hết job thì chuyển sang Purged | Có | Không |
purge | Xoá mọi bản ghi job trên volume, bất kể hạn | Không | Không |
| Recycle | Dùng lại một volume Purged: ghi đè từ đầu | Có (chỉ volume đã Purged) | Không, nhưng đĩa ngừng phình |
truncate | Cắt file volume Purged về gần 0 byte | Có (chỉ volume đã Purged) | Có |
Vòng đời một volume trên đĩa trông như sau:
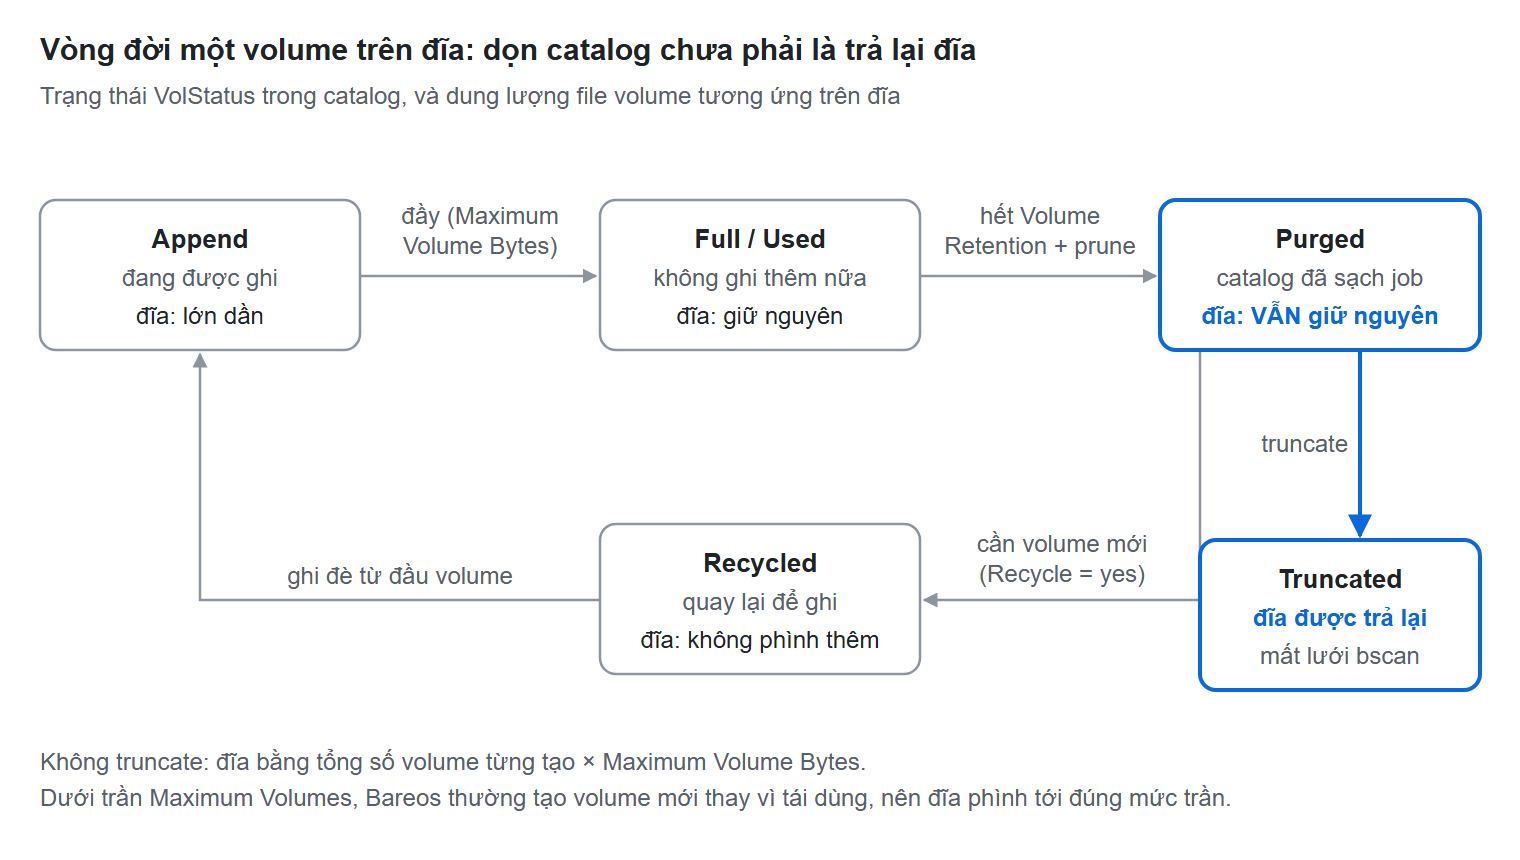
Nhìn vào sơ đồ sẽ thấy: tới trạng thái Purged, catalog đã sạch nhưng file volume vẫn nguyên kích thước. Đĩa chỉ được trả lại khi volume bị truncate, hoặc gián tiếp khi nó được tái dùng thay vì tạo volume mới.
Prune lười, và vì sao đĩa phình tới trần
Bareos không có tiến trình nền đi dọn volume hết hạn mỗi đêm. Việc prune volume thường chỉ xảy ra khi Director cần tìm chỗ ghi cho một job. Theo quan sát của chúng tôi, khi pool còn dưới Maximum Volumes và có Label Format, Bareos thường tạo volume mới cho nhanh thay vì dọn volume cũ.
Hệ quả: nếu không truncate, đĩa sẽ phình tới đúng mức Maximum Volumes × Maximum Volume Bytes rồi mới bắt đầu xoay vòng. Hai directive đó không phải con số trang trí. Chúng là trần cứng duy nhất của cả kho.
Ngược lại, đặt trần quá thấp thì job sẽ đứng chờ với thông báo kiểu Cannot find any appendable volumes. Mỗi lần nới đĩa, nhớ nới Maximum Volumes theo.
Truncate hay không truncate
Có hai cách bật truncate:
# Tự động: cắt file ngay lúc volume bị purge (khai trong resource Pool)
Action On Purge = Truncate

# Thủ công, trong bconsole: cắt mọi volume đang Purged của một pool
truncate volstatus=Purged pool=incr-30d yes
Đây là một đánh đổi thật, không có đáp án chung:
| Không truncate | Có truncate | |
|---|---|---|
df cho biết | Đã từng cấp phát bao nhiêu, không phải đang chứa bao nhiêu | Gần đúng dữ liệu đang sống |
Lỡ tay purge nhầm | Dữ liệu vẫn trên đĩa, còn cứu được bằng bscan | File đã bị cắt, mất hẳn |
| Kiểm soát đĩa bằng | Maximum Volumes là phanh duy nhất | Retention + truncate |
Nếu chọn không truncate, hãy ghi rõ cho người trực: con số trên biểu đồ đĩa là mức đã cấp phát. Nhìn thấy 80% dễ tưởng sắp đầy, trong khi phần lớn có thể là volume đã Purged đang chờ tái dùng.
Làm thật: xem volume nào đã quá hạn
Trong bconsole, xem trạng thái volume của một pool và dọn tay một volume:
list volumes pool=incr-30d
llist volume=incr-30d-0042
prune volume=incr-30d-0042 yes
Muốn nhìn toàn cảnh, hỏi thẳng catalog. Câu dưới liệt kê volume đã quá Volume Retention nhưng vẫn ở trạng thái Full/Used, tức vẫn chiếm đĩa:
SELECT m.volumename, p.name AS pool, m.volstatus, m.lastwritten,
       pg_size_pretty(m.volbytes) AS dung_luong
FROM media m
JOIN pool p ON p.poolid = m.poolid
WHERE m.volstatus IN ('Full', 'Used')
  AND m.lastwritten + m.volretention * interval '1 second' < localtimestamp
ORDER BY m.lastwritten;
VolRetention lưu bằng giây. LastWritten là timestamp không kèm múi giờ, nên so với localtimestamp và nhớ đặt đúng timezone cho PostgreSQL như bài 2 đã nhắc.
Những cái bẫy vận hành
Sửa Pool không sửa volume đã có
Retention, Action On Purge, Recycle được chép vào từng volume lúc volume được tạo. Đổi giá trị trong file Pool rồi reload chỉ ảnh hưởng volume mới. Volume cũ vẫn mang giá trị cũ cho tới khi bạn cập nhật chúng:
update pool=incr-30d
update volume allfrompool=incr-30d
Lệnh thứ nhất đưa giá trị trong file vào bản ghi pool trong catalog. Lệnh thứ hai chép xuống mọi volume của pool. Kiểm lại bằng llist volume=… trước khi tin.
Đồng hồ retention vẫn chạy khi tạm dừng backup
Tạm dừng backup (bảo trì, chuyển kho, sự cố) không làm volume ngừng già đi. Dữ liệu không tự mất ngay, vì prune lười. Nhưng khi bật lại, job đầu tiên có thể kích hoạt một đợt prune rất lớn: sau vài tuần tạm dừng, phần lớn kho có thể đã quá hạn cùng lúc.
Nguy hiểm hơn: nếu pool đã chạm trần, Bareos có thể tái dùng chính volume chứa bản tốt cuối cùng trước khi bản Full mới chạy xong. Trước khi bật lại sau một đợt tạm dừng dài, hãy chạy câu SQL ở trên, xem phạm vi sẽ bị dọn, và cân nhắc nới tạm volretention cho những volume cần giữ.
Lệnh purge chạy tay là lệnh nguy hiểm nhất
Prune tôn trọng retention, purge thì không. Trên hệ không truncate, purge nhầm vẫn còn đường cứu. Trên hệ có Action On Purge = Truncate, purge nhầm là mất ngay. Nếu bật truncate, nên giới hạn ai được chạy purge.
Rác Incremental mồ côi: thứ Bareos không tự dọn
Bareos dọn theo volume, và nó không kiểm "bản Full này còn Incremental nào đang dựa vào không". Trong quá trình vận hành, đội kỹ thuật Cloudzone từng gặp một kho mà một phần đáng kể dung lượng Incremental là những bản không còn dùng để dựng lại trạng thái đầy đủ được nữa.
Rác kiểu này sinh ra từ hai nguồn:
- Bản Full hết hạn trước các Incremental đi sau nó. Với Full giữ 45 ngày, Incremental giữ 30 ngày, các Incremental cuối chu kỳ còn sống thêm ít ngày sau khi Full của chúng đã bị dọn.
- Incremental đầu chuỗi hết hạn trước đuôi chuỗi, cùng một retention nhưng ghi sớm hơn. Lượng rác loại này phụ thuộc độ dài chuỗi, không phụ thuộc con số retention.
Một lưu ý quan trọng với backup mức file: một Incremental mồ côi vẫn chứa nguyên các file đã đổi trong ngày đó, nên vẫn cứu được file lẻ. Nó chỉ không dựng lại được trạng thái đầy đủ của máy chủ. Dọn hay không là quyết định chính sách, nên ghi rõ trong tài liệu vận hành.
Tìm: hỏi trạng thái hiện tại, đừng bắt sự kiện
Bareos không lưu quan hệ "Incremental này dựa trên Full nào", và việc auto-prune diễn ra bên trong Director, không phát ra sự kiện nào. Cách bền nhất là mỗi lần quét, hỏi lại catalog: Incremental này còn bản Full thành công nào đứng trước nó không?
SELECT j.jobid, j.name, j.level, j.starttime,
       pg_size_pretty(j.jobbytes) AS dung_luong
FROM job j
JOIN pool p ON p.poolid = j.poolid
WHERE j.type = 'B'
  AND j.level IN ('I', 'D')
  AND j.jobstatus IN ('T', 'W')
  AND j.name LIKE 'backup-%'          -- danh sách trắng: tên job theo quy ước
  AND p.name LIKE 'incr-%'            -- và pool do mình quản lý
  AND j.starttime < localtimestamp - interval '7 days'
  AND NOT EXISTS (
        SELECT 1 FROM job f
        WHERE f.name = j.name
          AND f.type = 'B'
          AND f.level IN ('F', 'f')   -- 'f' là Virtual Full
          AND f.jobstatus IN ('T', 'W')
          AND f.jobtdate <= j.jobtdate)
ORDER BY j.jobbytes DESC;
Câu này chỉ bắt được nguồn thứ nhất (mất Full). Nguồn thứ hai cần thêm kiểm tra khoảng trống trong chuỗi, phức tạp hơn nhiều. Vài điều kiện trong câu đáng giải thích:
- Phân biệt máy chủ bằng tên job, không bằng volume: một volume thường chứa job của nhiều máy chủ.
- Tính cả level
'f'. Bỏ sót Virtual Full thì Incremental dựa trên nó bị coi là mồ côi, tức xoá oan bản còn dùng được. - Chỉ tính Full thành công (
'T','W'). Full lỗi không đỡ được ai. - Tuổi tối thiểu. Rác thật thì luôn cũ. Một job mới mà bị liệt vào mồ côi là dấu hiệu lỗi logic, không phải rác.
Dọn: lan can quan trọng hơn câu SQL
Câu truy vấn đúng chưa đủ. Rủi ro thật nằm ở khâu thực thi:
- Danh sách trắng kép: tên job theo quy ước và pool của mình. Job
BackupCatalogthường nằm trong một pool dựng sẵn, lọc hời hợt là chạm vào chính bản backup của catalog. - Chỉ sinh đúng một dạng lệnh:
delete jobid=…, JobId ép kiểu số. Đừng để công cụ có khả năng sinhdelete volume=, vì một volume chứa job của nhiều máy chủ. - Xác minh lại ngay trước khi xoá bằng
list jobid=…trên đúng Director đó, đối chiếu tên, level, thời gian. Lệch một chỗ thì dừng toàn bộ. - Phanh số lượng: vượt một ngưỡng thì không xoá gì, chỉ cảnh báo. Catalog bị khôi phục từ bản cũ có thể làm cả nghìn job bỗng "mồ côi".
- Ghi nhật ký trước khi xoá, không phải sau.
Và đừng kỳ vọng đĩa giảm ngay. Xoá bản ghi job không gọt được byte giữa volume, vì volume là luồng ghi tuần tự. Volume chỉ về Purged khi mọi job trên nó biến mất, nên lợi ích là volume được tái dùng sớm hơn, trần đĩa dừng thấp hơn.
Nên bắt đầu bằng chế độ chỉ báo cáo, đối chiếu tay vài chục ca trong vài tuần. Khi mọi ca đều đúng mới thêm nút xoá có người bấm, rồi mới nghĩ tới tự động.
Tóm tắt
- Đĩa được giải phóng theo volume.
Volume Retentiontrên pool mới là thứ quyết định, tính từ lần ghi cuối vào volume. - Muốn Full giữ lâu hơn Incremental thì tách pool theo level. Một mốc khôi phục chết theo mắt xích đầu chuỗi.
- Prune và purge chỉ làm sạch catalog. Không truncate thì đĩa phình tới
Maximum Volumes × Maximum Volume Bytes. - Sửa Pool không sửa volume đã có, và đồng hồ retention vẫn chạy khi tạm dừng backup.
- Incremental mồ côi không tự được dọn. Tìm bằng cách hỏi catalog, dọn với danh sách trắng và nhiều lớp xác minh.
Bài sau: Tính dung lượng backup theo đỉnh, đừng theo trung bình — vì sao công thức "1,5 bản Full" thường báo thiếu, và cách mô phỏng từng ngày để đặt trần pool cho đúng.
Bài viết thuộc chuỗi “Bareos từ cài đặt tới vận hành” của đội kỹ thuật Cloudzone.